
Nota: Este artigo foi traduzido automaticamente com OpenAI GPT-5.5 por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Jev
Uma nova startup chamada TypeSafe AI chamou bastante atenção esta semana com o lançamento de seu modelo chamado Jev. Apesar de ter recebido muito hype como se fosse um LLM, na verdade não é.
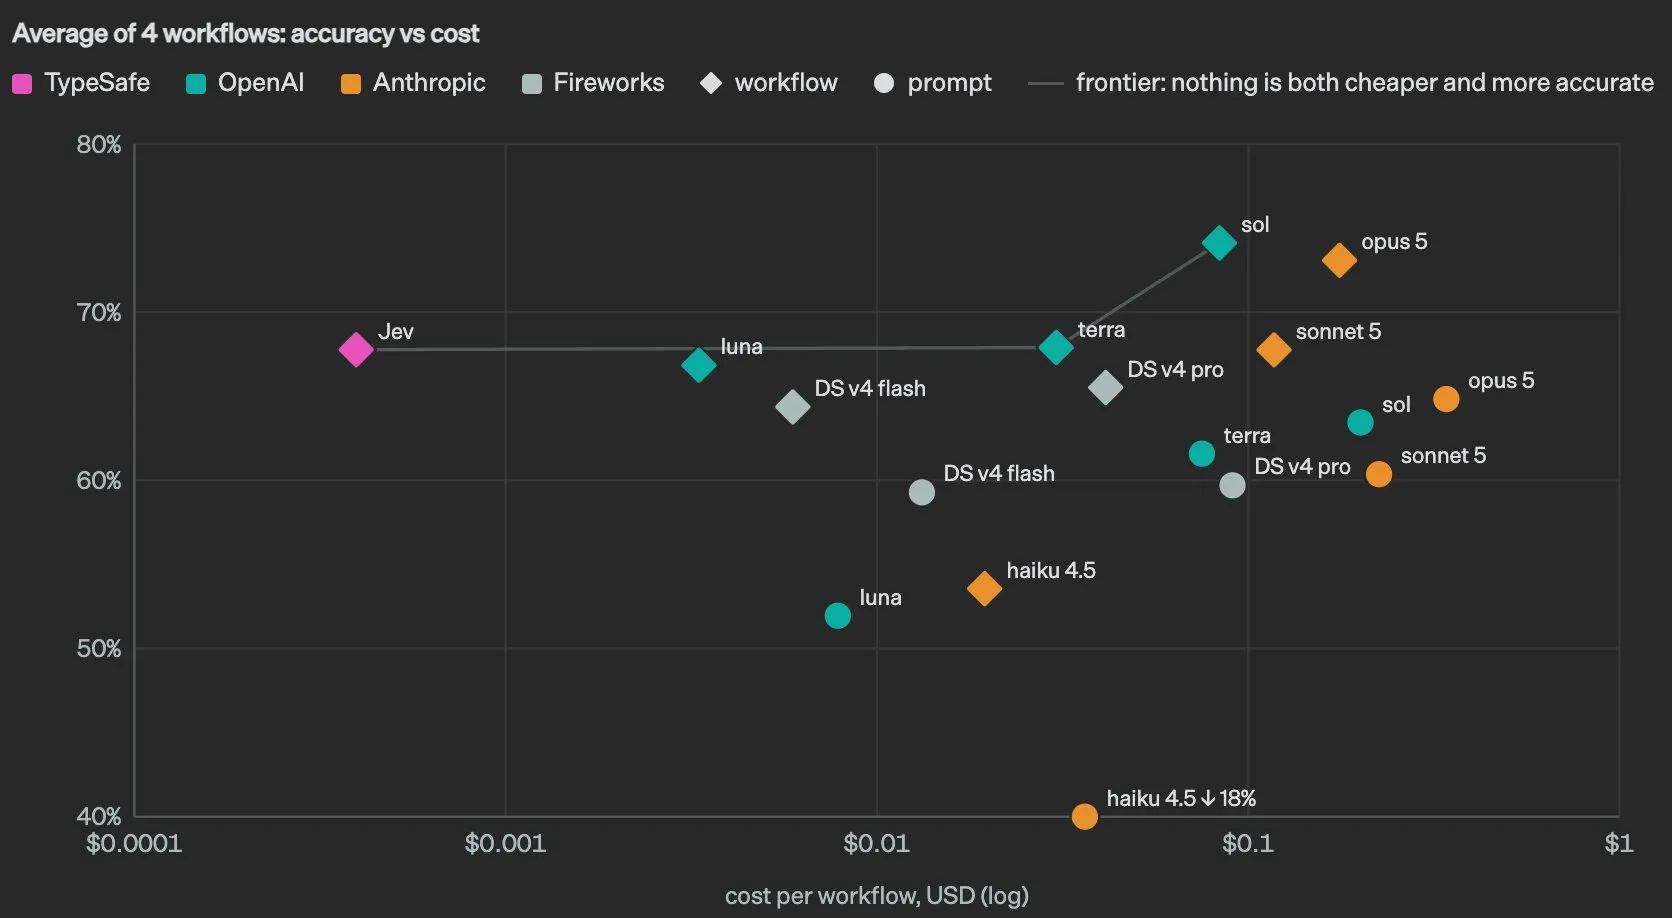
Em vez disso, ele é o que se conhece como um modelo de classificação zero-shot. Isso significa que você fornece a ele um trecho de texto e um conjunto de categorias, e ele dará uma probabilidade para o texto em cada categoria.
Esses modelos tendem a ser muito pequenos e, como eles apenas produzem probabilidades, você só precisa pagar pelos tokens de entrada. Isso significa que o Jev custa apenas 4,2 centavos por milhão de tokens de entrada, e você não paga nada por tokens de saída, já que não há nenhum.
Isso pode parecer revolucionário (como muitas pessoas no Twitter acham), mas se você acompanha IA desde antes da explosão cambriana do ChatGPT, sabe que isso não é tão revolucionário assim; treinamos esses modelos (conhecidos como modelos BERT) desde 2020!
Temos uma variedade de modelos que já fazem isso (como o Modern Bert Zeroshot), e eles são muito fáceis de treinar (eu treinava esses modelos no meu laptop lá em 2021!). Ao contrário dos modelos de IA generativa, esses modelos de ML mais tradicionais são muito mais fáceis de treinar e implantar; eles podem rodar facilmente no navegador do seu usuário, até mesmo em dispositivos móveis.
Pronto para uso, o Jev é uma versão melhor do que temos hoje em código aberto e também supera os LLMs baratos que as pessoas têm usado para tarefas de classificação (como Gemini 3.5 Flash Lite e GPT 5.6 Luna), mas sua viralidade já gerou vários clones (muitos deles de código aberto), então espero que a diferença diminua rapidamente.
Também vale notar que esses são modelos zero-shot, o que significa que eles não foram treinados para a tarefa específica de classificação em que estão sendo usados. Como eu disse antes, esses modelos são muito fáceis de ajustar por finetuning, exigindo apenas algumas dezenas de amostras para treinar, e isso pode ser feito na maioria dos hardwares domésticos, sem necessidade de GPU. Essas variantes ajustadas por finetuning vão superar amplamente os modelos zero-shot (e os LLMs), sendo efetivamente gratuitas para você treinar e executar.
Dito isso, se você tem um pipeline de classificação e está usando LLMs nele, eu os substituiria pelo Jev, já que ele deve ser tão bom quanto, se não melhor que, a maioria dos LLMs, além de ser muito mais barato e rápido. Depois de fazer isso, eu investigaria o finetuning da sua própria versão para reduzir seus custos a 0.
Pesquisa
Weird ML V3
Falando em fazer finetuning de modelos, um novo benchmark de finetuning foi lançado: Weird ML V3.
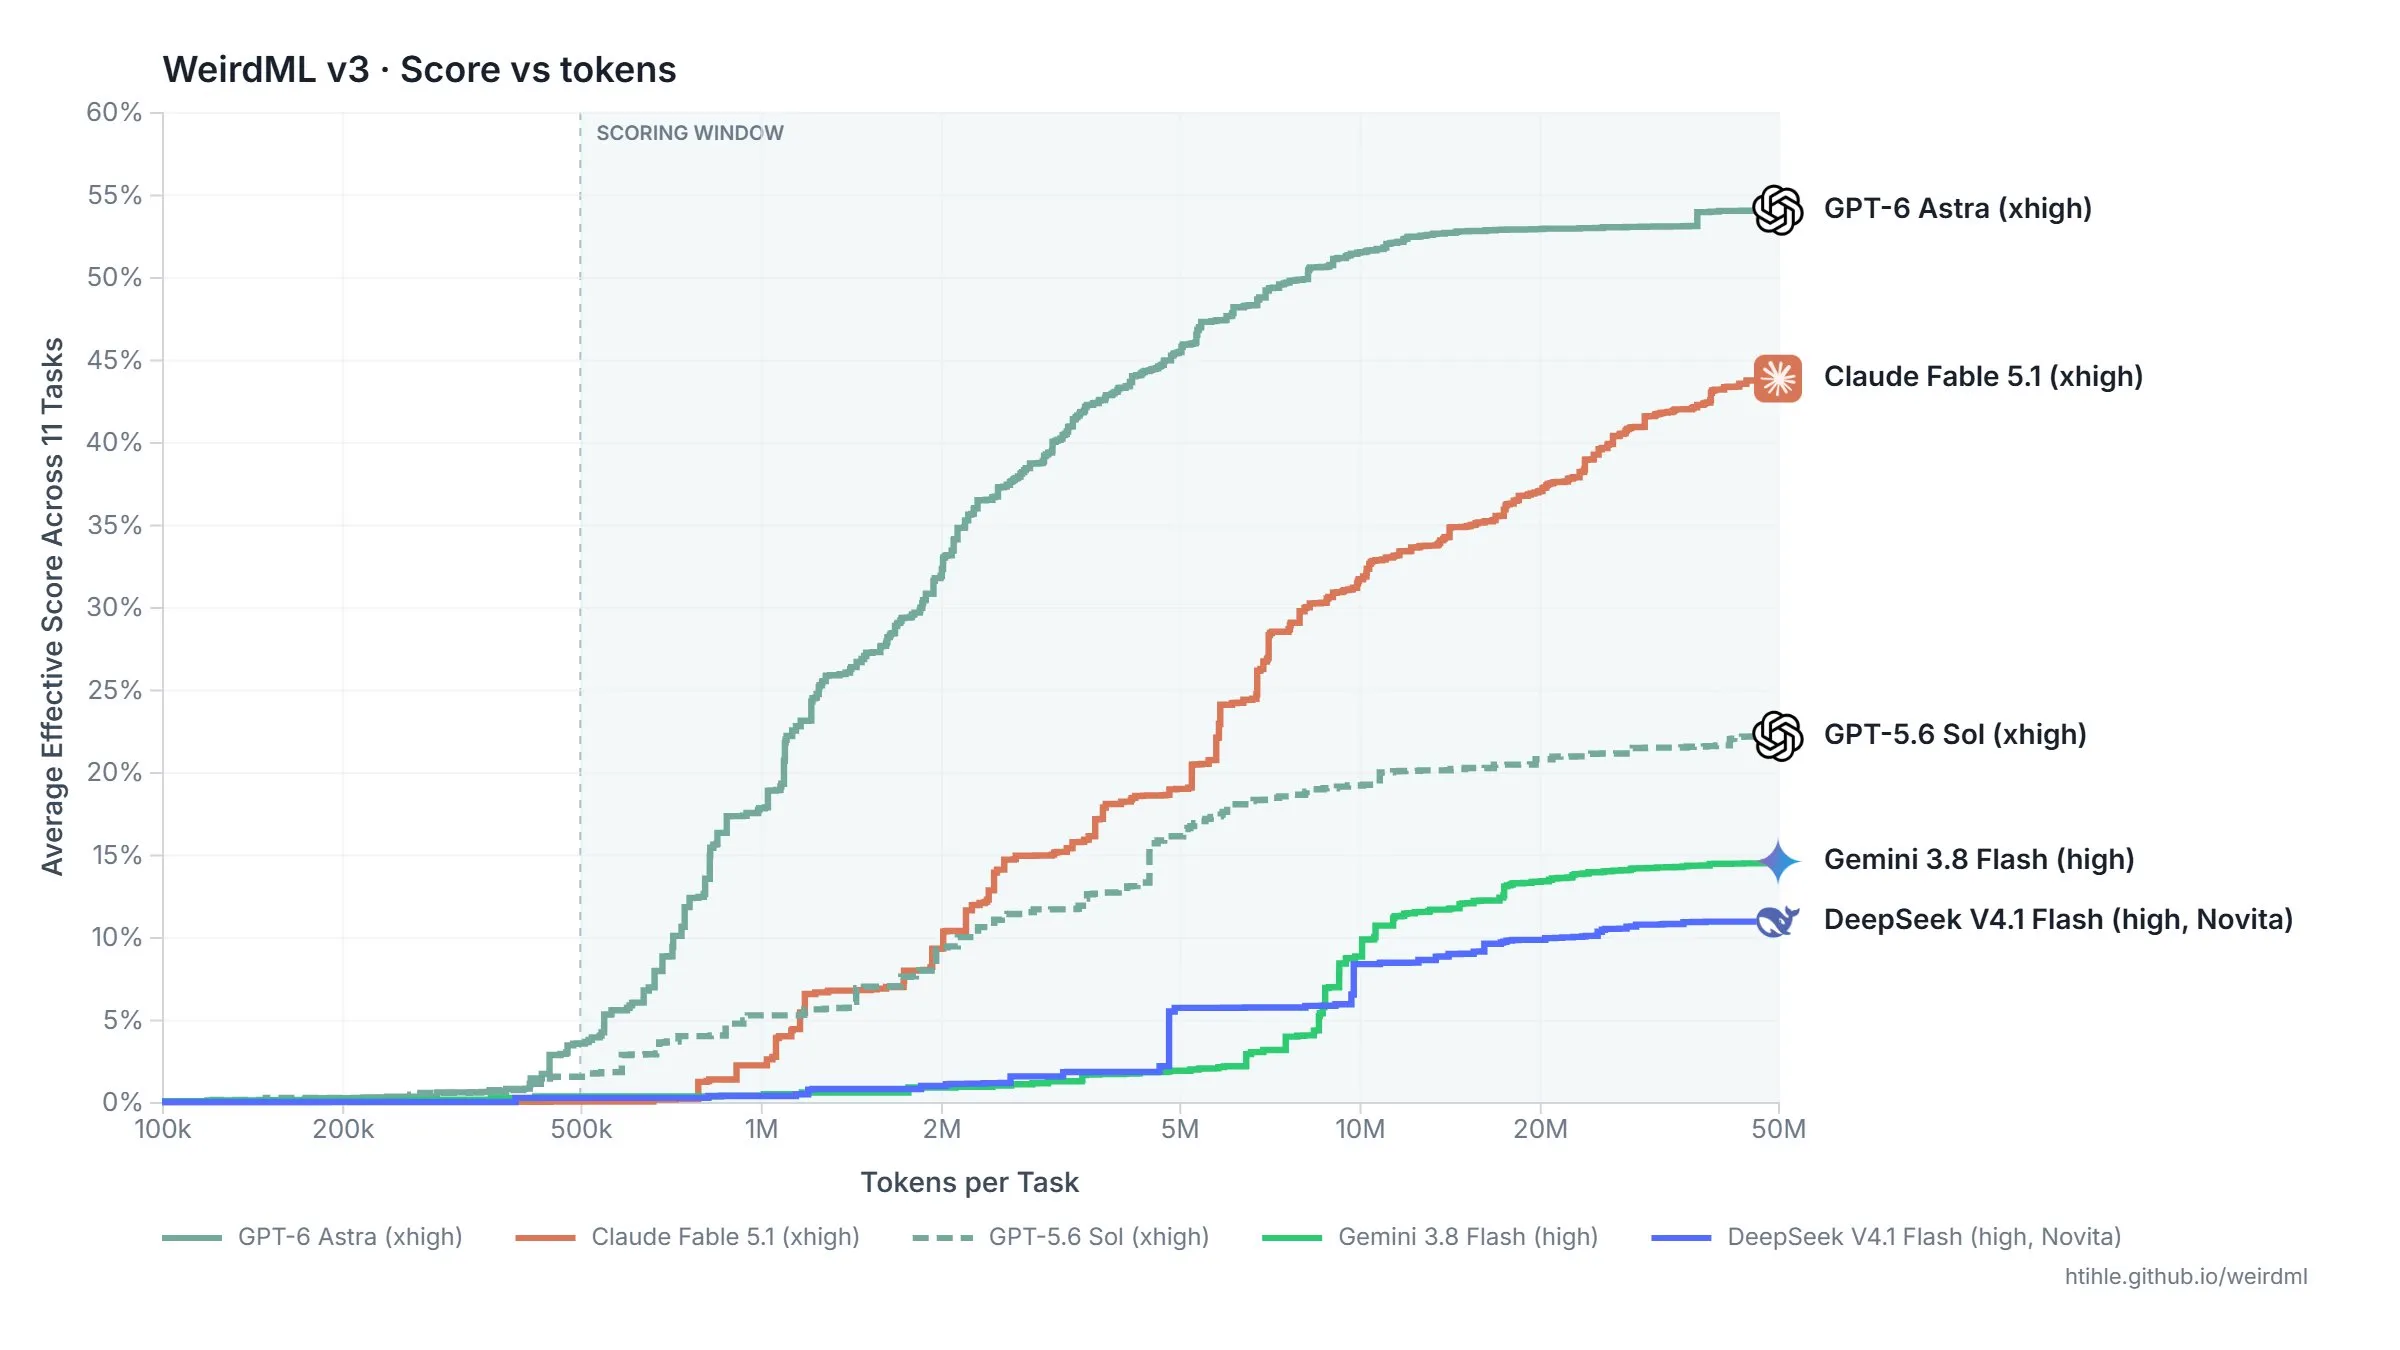
O benchmark mede o quão bem o modelo consegue se sair quando é colocado em um ambiente de machine learning com pouca orientação além da tarefa em si. Cabe ao modelo examinar os dados, filtrá-los e processá-los, decidir qual arquitetura usar para o modelo real e então compor um pipeline para treinar o modelo com sucesso (eles têm apenas 2 minutos de computação para treinar, então precisam garantir que o modelo seja eficiente).
A iteração anterior era um bom benchmark (a Epoch AI recentemente avaliou o benchmark e não encontrou problemas nele, o que é surpreendentemente raro), mas estava ficando saturada pelos modelos de ponta, então era hora de um novo benchmark.
Eles divulgaram 4 amostras (mantendo o restante dos problemas privado) do benchmark para dar uma ideia do que esperam dos modelos. As tarefas incluem detecção e classificação de formas, detecção de navios, processamento de sinais de dados de telescópio e bonanza, que reúne todas as 17 tarefas do Weird ML V2 que o modelo precisa resolver em paralelo, e a única pontuação que ele recebe é a média das 17 perguntas; portanto, ele precisa descobrir sozinho em quais está ou não indo bem.
O benchmark faz um bom trabalho ao diferenciar modelos, especificamente modelos abertos versus fechados. Modelos abertos tendem a ser treinados em torno dos principais benchmarks e tarefas de engenharia de software, e tendem a carecer de capacidades de codificação diversas, algo que a maioria dos benchmarks deixa passar. O Weird ML não tem esse problema, pois há uma grande diferença entre a maioria dos modelos, o que oferece uma boa medida de generalidade.
Nas pontuações preliminares, vemos isso: Fable e GPT-6 Astra estão muito à frente, com GPT-6 na liderança devido às suas capacidades superiores de compreensão de imagem, já que muitos dos problemas se beneficiam de fortes capacidades multimodais. DeepSeek V4.1 Flash e Gemini 3.8 Flash, que parecem próximos da fronteira em muitos benchmarks, ficam perceptivelmente atrás.
Weird ML V3 será adicionado à lista de benchmarks que uso para as notícias, o que é bom de ver, já que muitos dos benchmarks em que eu confiava foram contaminados (como DeepSWE), mas essa é uma discussão para outro dia.
Encerramento
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, não deixe de entrar na nossa lista de emails abaixo.