注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Inkling 2 Small 到底怎么样?
前 OpenAI 联合创始人 Mira Murati 创办的初创公司 Thinking Machines 此前一直相对低调,发布过托管式大语言模型训练平台 Tinker,以及表现颇为平庸的大语言模型 Inkling 1。不过,随着 Inkling 2 Small 的发布,他们似乎正试图确立自己作为一家实力不容小觑的前沿实验室的地位。
首先,把这个模型叫作“小型”有点名不副实,因为它有近 6000 亿个参数,部署时需要超过 300GB 的 GPU 显存。 在这个领域发展的早期,小型模型指的是参数量低于 100 亿的模型,大型模型则超过 1000 亿,介于两者之间的就是中型模型。 如今,除了 Qwen 和 Liquid AI,已经没人做参数量低于 1000 亿的模型了,而不到 1 万亿参数的模型都算“小型”。不过,我扯远了。
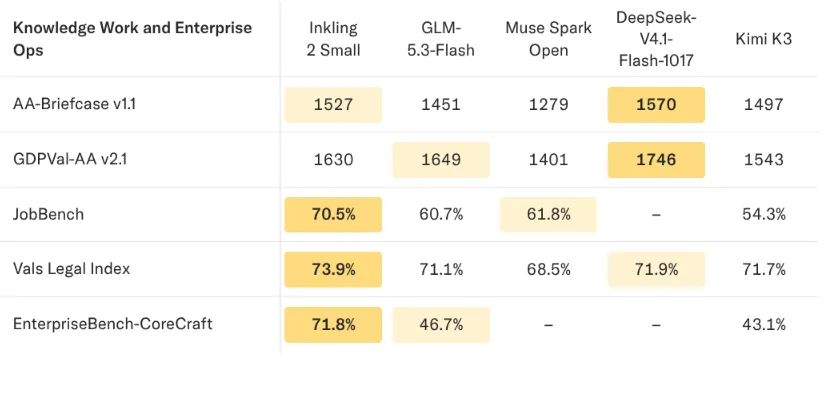
Inkling 2 Small 的定位是速度快、价格低、表现好的模型,与 DeepSeek V4.1 Flash 1017、GLM 5.3 Flash、GPT 6 Luna 和 Haiku 5.5 属于同一类。
在编程方面,它确实略逊于 Haiku 和 DeepSeek,但仍有一战之力,差距也不算大。
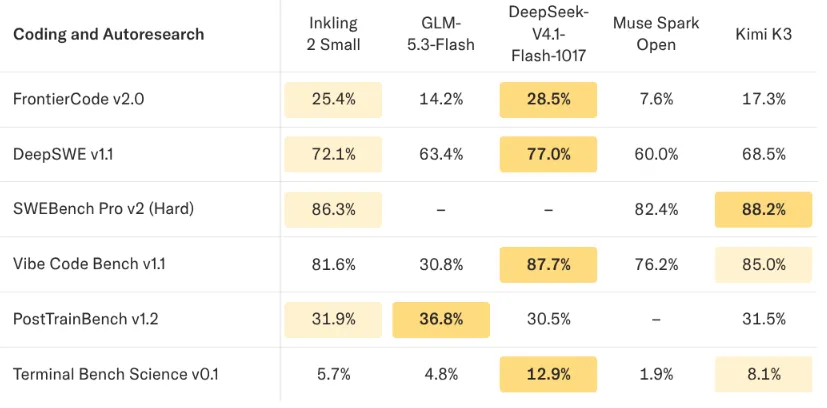
不过,它在其他大多数类别中都表现突出,在金融和法律基准测试、图像理解以及设计方面都有很强的实力,也是 Design Arena 上排名靠前的模型之一。
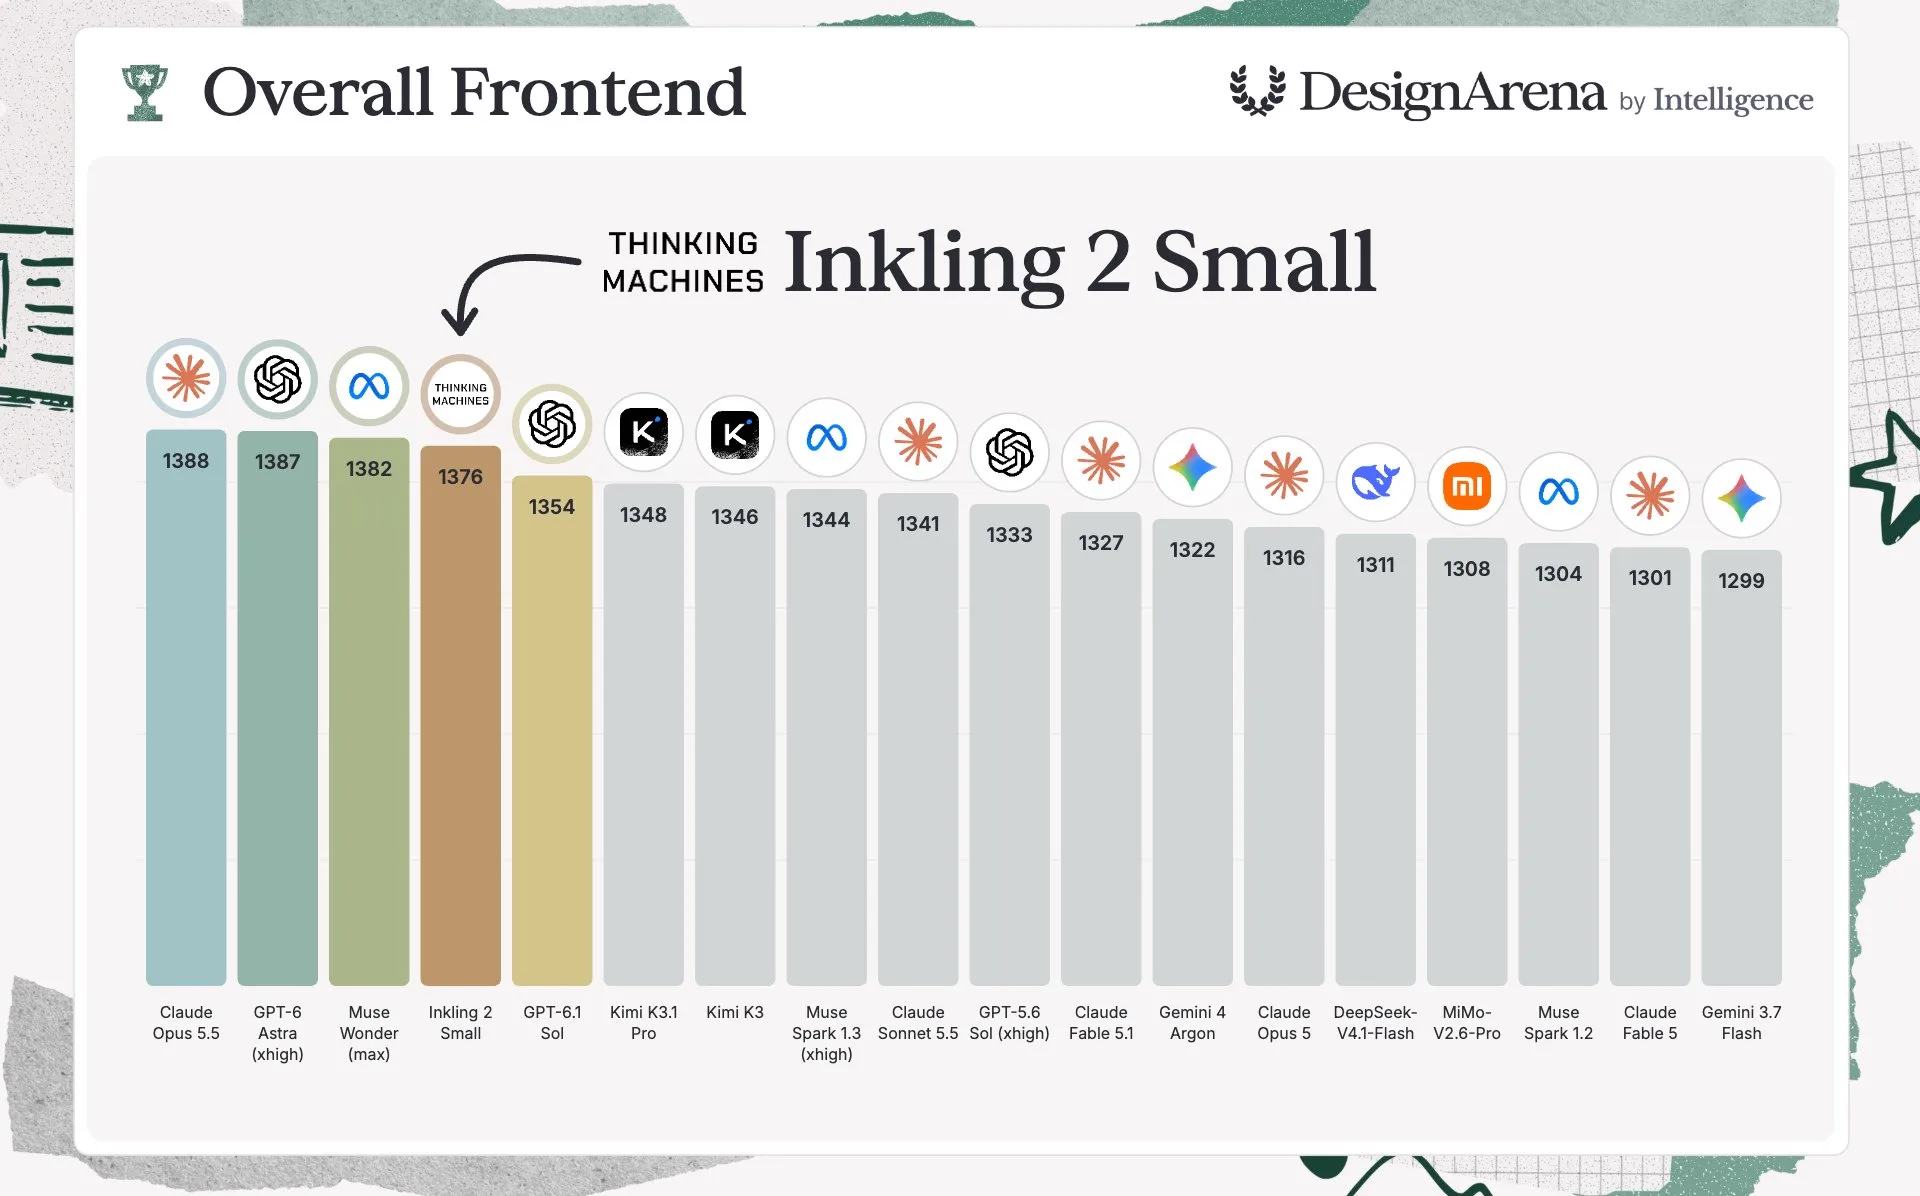
这个模型的设计能力,来自注重审美品位的训练。 通常,人们认为训练使用的 token 越多越好,但 Thinking Machines 却反其道而行之,预训练使用的 token 数量只有初代 Inkling 模型的四分之一左右(12 万亿,而初代为 45 万亿)。 他们还注重合成环境的质量,而非单纯追求数量,并借鉴了 Frontier Code 的一些思路,例如评估模型解决问题的过程,而不只是看它的代码能否通过测试。 这种训练也让模型更易于微调,而初代 Inkling 在这方面一直表现不佳。
这指向了一个有趣的方向:数据并非越多越好。这与那些笃信规模扩展的传统研究者的观点背道而驰。
Inkling 2 Small 将于下周某个时候以 Apache 2 许可证开源。 过去一年里,我一直说,“美国最佳开源模型”这个头衔有点像一个毫无意义的奖项,因为美国推出的模型质量实在不怎么样。但 Thinking Machines 似乎正在扭转这一局面,成为开源领域一个不容小觑的竞争者。 接下来几周,我肯定会穿插着用一用 Inkling 2,也期待 Thinking Machines 未来发布的新模型(也许会更大?)。
结语
希望你喜欢本周的新闻。如果你想每周收到新闻,请务必加入下方的邮件订阅列表。