
Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
GPT 5.4
A OpenAI lançou uma atualização para sua série de modelos GPT 5 esta semana. O GPT 5.4 é o seu mais recente modelo de raciocínio, pulando o GPT 5.3, pois suas capacidades ampliadas justificam um salto de versão maior que 0.1, segundo a OpenAI.
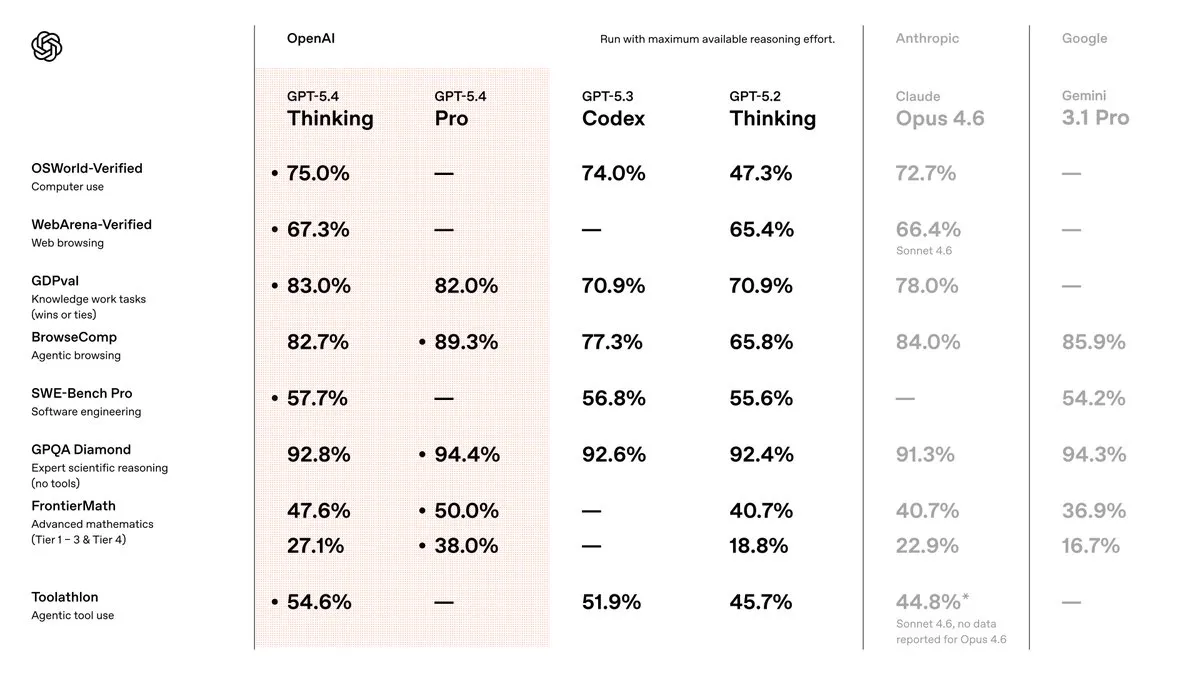
O GPT 5.3 Codex já estava empatado com o Opus 4.6 para casos de uso em programação, mas ficou para trás em casos de uso mais gerais do dia a dia. O GPT 5.4 parece corrigir esses problemas para ser o melhor modelo disponível, e, salvo alguns casos de uso específicos, eles parecem ter conseguido.
Em termos de inteligência bruta e capacidade de realizar tarefas, o GPT 5.4 é o melhor modelo disponível no momento. É forte em raciocínio, navegação na web, casos de uso com agentes e programação. Também possui a menor taxa de alucinação de qualquer modelo atualmente.
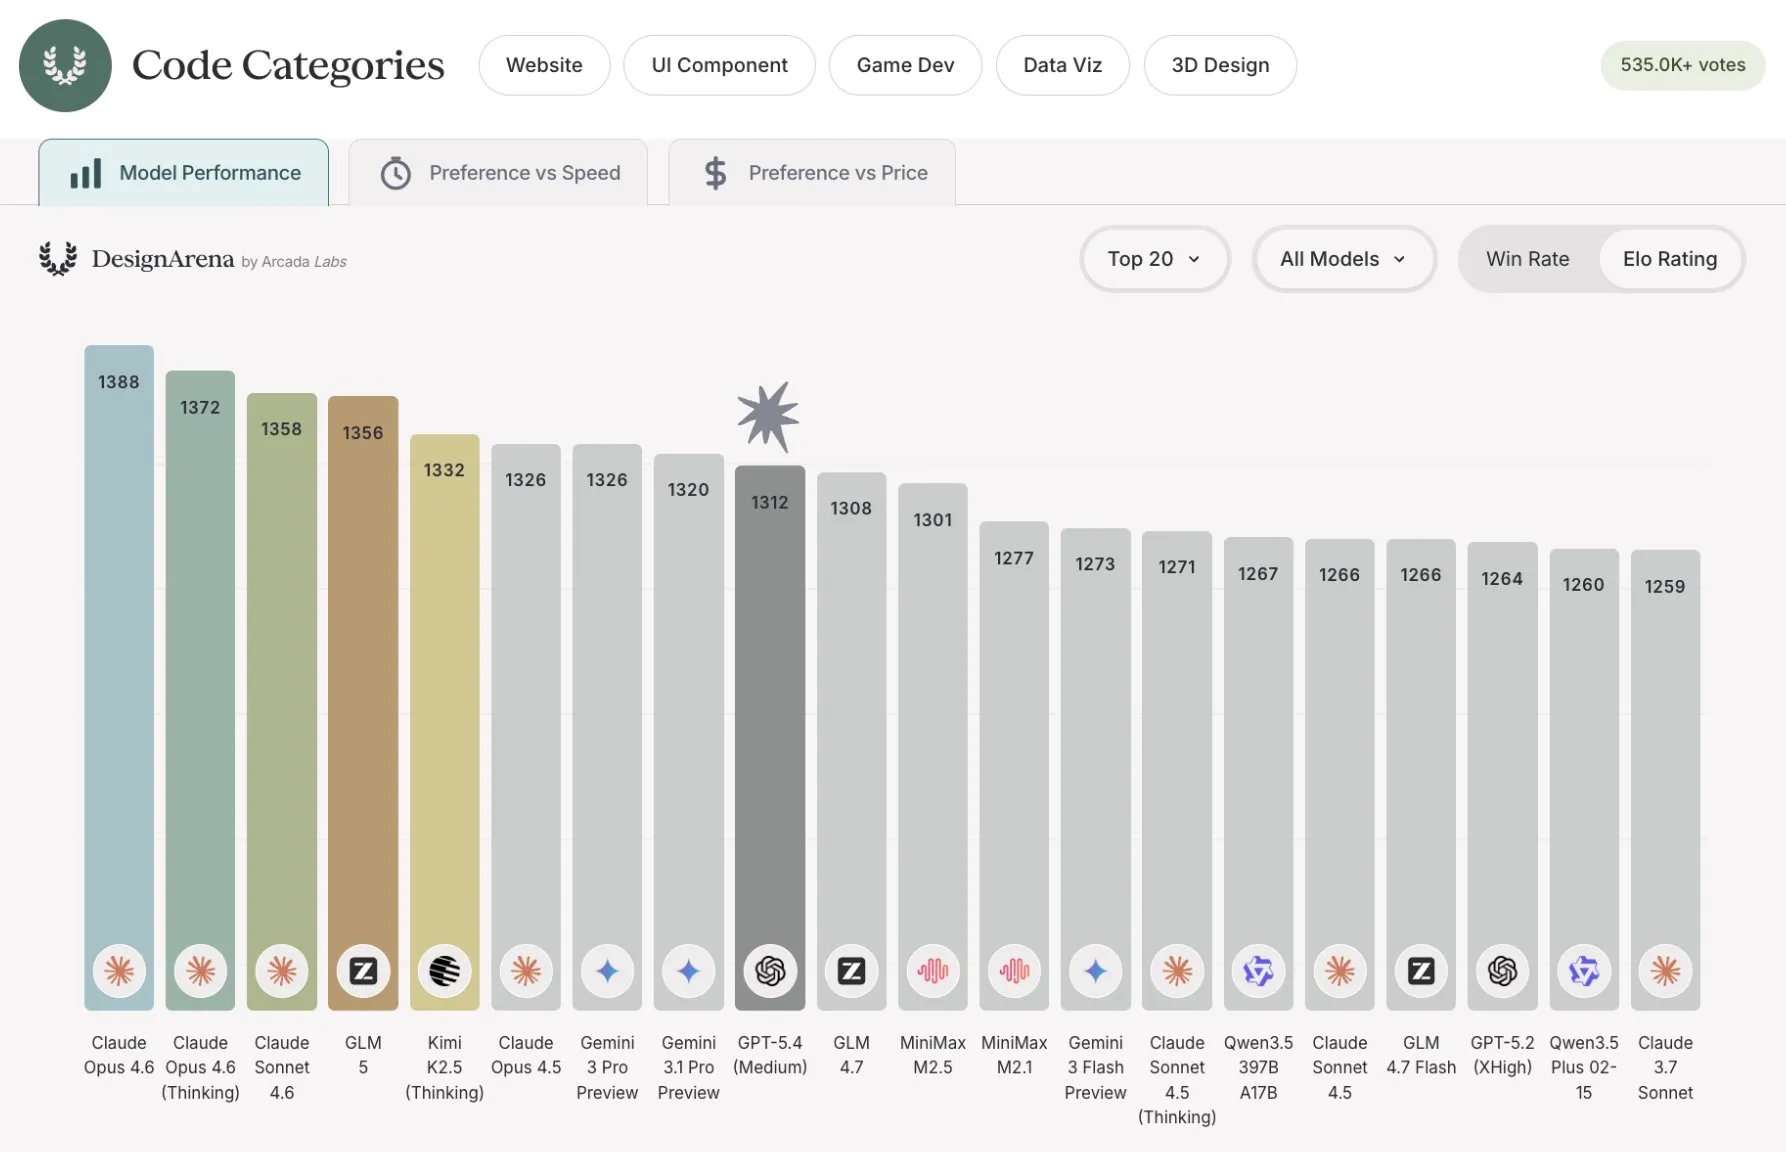
Os poucos pontos onde o modelo falha são os mesmos onde o GPT tem sido fraco e o Claude tem se destacado: personalidade, estilo de escrita e design. Podemos ver isso em benchmarks como o Design Arena, onde o GPT 5.4 ocupa o 18º lugar, atrás do Claude, do Gemini e até de alguns LLMs chineses.
Ele também fica atrás de seu predecessor focado em programação, o GPT 5.3 Codex. Tem um melhor estilo de escrita de código e compreensão de intenção (embora ainda não tão bom quanto o Claude para vibe coding), mas não parece ter a mesma aversão a bugs que o 5.3 tinha.
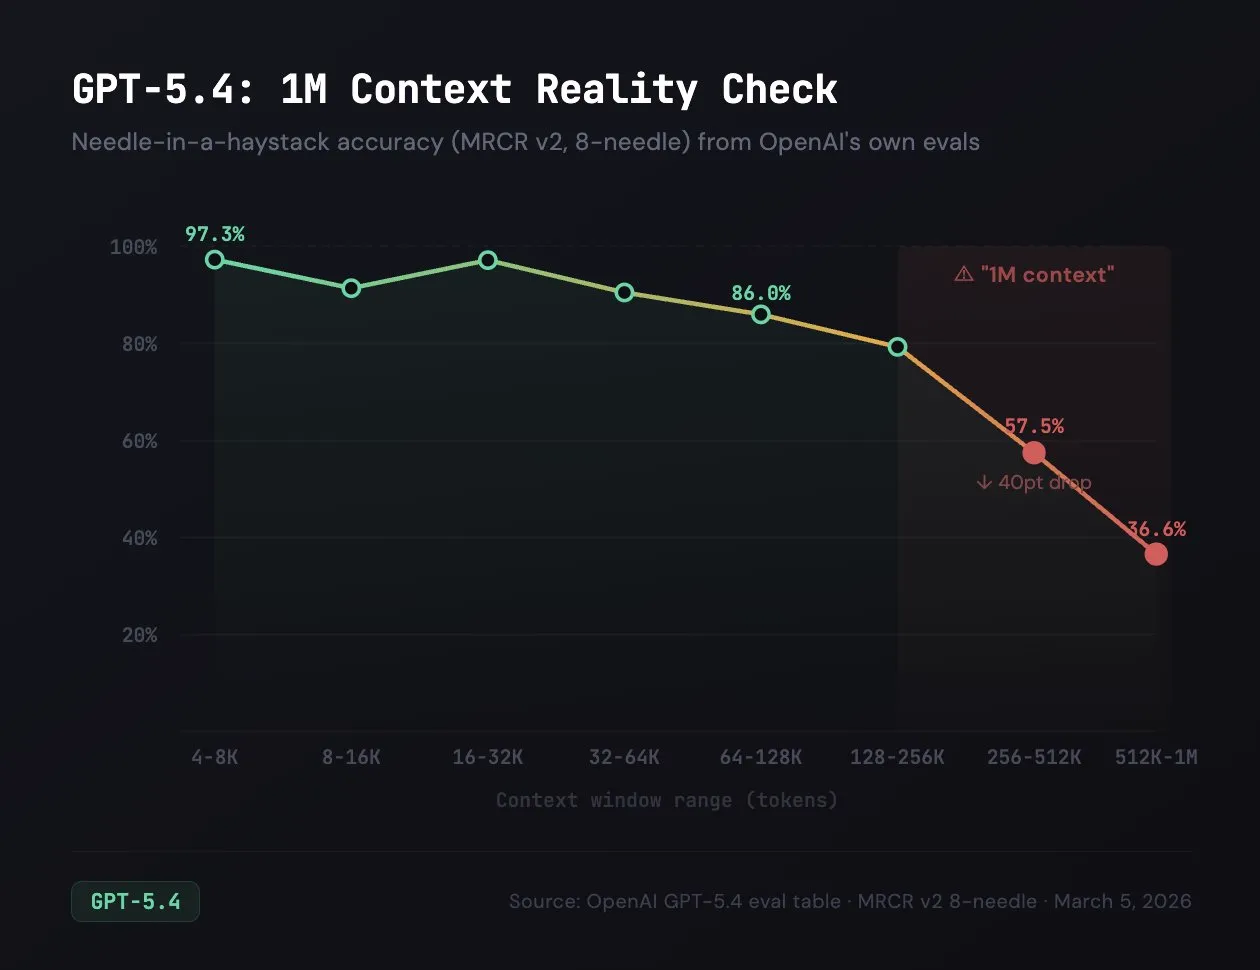
A OpenAI também está lançando uma versão experimental do modelo com 1 milhão de tokens de contexto, aproximadamente quadruplicando o número de tokens que podem ser fornecidos ao modelo. Porém, só porque possuem esse recurso não significa que ele seja bom, pois até mesmo os benchmarks da própria OpenAI mostram uma queda massiva de qualidade após ultrapassar o limite de 256k tokens. Por isso, recomendo evitar a versão de um milhão de contexto, especialmente porque os tokens acima de 256k são cobrados em dobro.
Falando em preços, esse é outro aspecto que mudou. Devido ao “aumento nas capacidades do modelo”, a OpenAI decidiu elevar os preços de forma semelhante ao que fez com o GPT 5.2.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GPT 5.4 | $2,50 | $15 | 50 |
| GPT 5.2 | $1,75 | $14 | 46 |
| GPT 5 | $1,25 | $10 | 46 |
| Claude Sonnet 4.5 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| Gemini 3 Pro Preview | $2 | $12 | 80 |
| GLM 5 | $1 | $3,20 | 21 |
| MiniMax M2.5 | $0,30 | $1,20 | 27 |
Isso significa que, desde o lançamento original do GPT 5, o preço dos tokens de entrada dobrou e o preço dos tokens de saída subiu 50%. Ainda são muito mais baratos que o Opus, mas agora têm preços similares ao Sonnet, abrindo um pouco mais espaço para a Anthropic competir.
No geral, o GPT 5.4 é um modelo muito forte, e recomendo fortemente experimentá-lo para tarefas do dia a dia, usos agênticos e programação.
Qwen 3.5 Small
A Qwen lançou os modelos para o último tamanho de sua nova linha Qwen 3.5, sendo os modelos Qwen 3.5 small. Estamos recebendo 4 modelos diferentes, com tamanhos de 0,8B, 2B, 4B e 9 bilhões de parâmetros, todos modelos regulares sem mistura de especialistas (non-mixture-of-experts).
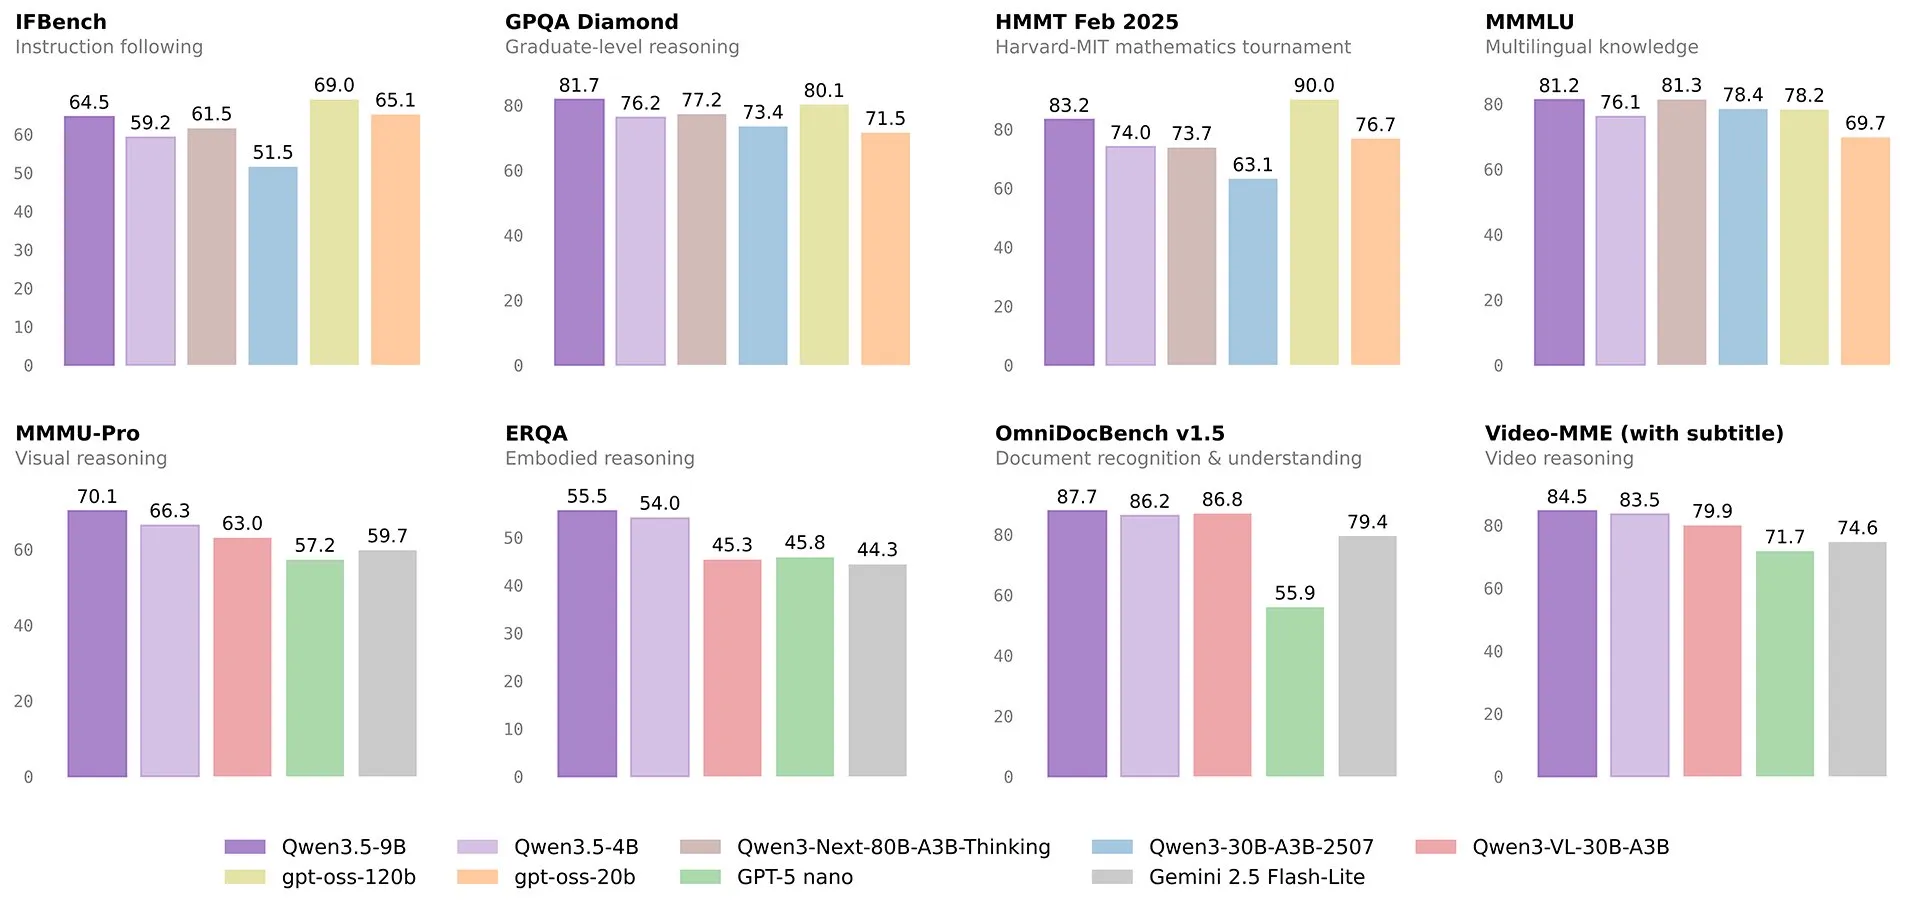
Assim como todos os outros modelos da linha Qwen 3.5, são modelos de raciocínio híbrido (é possível ativar e desativar o raciocínio) e também suportam entradas multimodais nativamente.
Eles têm sido comparados ao GPT 4o (um modelo com mais de um trilhão de parâmetros que era o estado da arte há 2 anos), especificamente sobre como são simplesmente melhores que ele na maioria dos benchmarks de inteligência, além de serem modelos agênticos muito mais robustos.
O aspecto um tanto incômodo, porém, é que eles não são realmente os melhores modelos pequenos disponíveis no momento. Esse título ainda pertence ao Nanbeige, que em benchmarks lançados nas últimas 2 semanas (impossível de ajustar para benchmarks que ainda não existiam) ele supera com folga os novos modelos Qwen de 4B e 9B, tudo isso com apenas 3B de parâmetros.
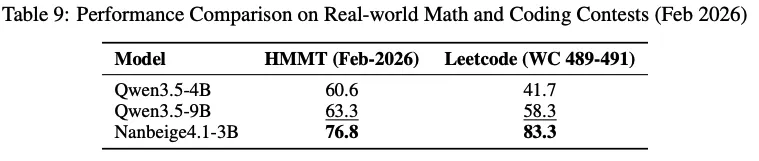
Isso não significa que os modelos Qwen sejam inúteis. O NanBeige tende a pensar por um longo tempo antes de responder até mesmo consultas simples (sem possibilidade de desativar o raciocínio) e também não possui suporte multimodal.
Portanto, se você gosta de executar modelos em casa (ou no celular), ainda recomendo conferir esses novos modelos pequenos Qwen 3.5.
Destaques Rápidos
GPT 5.3 Instant
Em um desdobramento intrigante, a OpenAI lançou tanto o GPT 5.4 quanto o 5.3 esta semana.
Isso porque o 5.3 é o modelo instant, visto principalmente por quem usa o plano gratuito do ChatGPT. Este é o modelo sem raciocínio da família GPT 5 (anteriormente chamado de raciocínio mínimo), e historicamente tem sido muito inferior aos seus irmãos contemplativos.
Com este lançamento, acredito que a OpenAI está tentando mostrar que esse modelo é completamente separado do GPT 5.4, e não apenas um nível de raciocínio mais baixo, mas sim um modelo inteiramente diferente (e menor).
O modelo não tem nada de especial; sempre que você vê o ChatGPT agindo de forma estranha, geralmente é o modelo instant. Este lançamento parece melhorar um pouco a personalidade e o estilo de escrita do modelo, e eles também afirmam ter reduzido a taxa de alucinação (sem benchmarks para comprovar).
Para os benchmarks que divulgam, há pouca ou nenhuma mudança em relação às versões anteriores do modelo.
Por isso, imploro que você use o GPT 5.4 sempre que possível e evite o modelo instant para tudo, exceto suas consultas mais simples.
Encerramento
Espero que você tenha gostado das novidades desta semana. Se quiser receber as notícias toda semana, não deixe de se inscrever em nossa lista de e-mails abaixo.