
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
GPT 5.4
OpenAI 本周为其 GPT 5 系列模型发布了更新。 GPT 5.4 是其最新的推理模型,直接跳过了 GPT 5.3。OpenAI 表示,它的能力提升幅度足以让版本号不止增加 0.1。
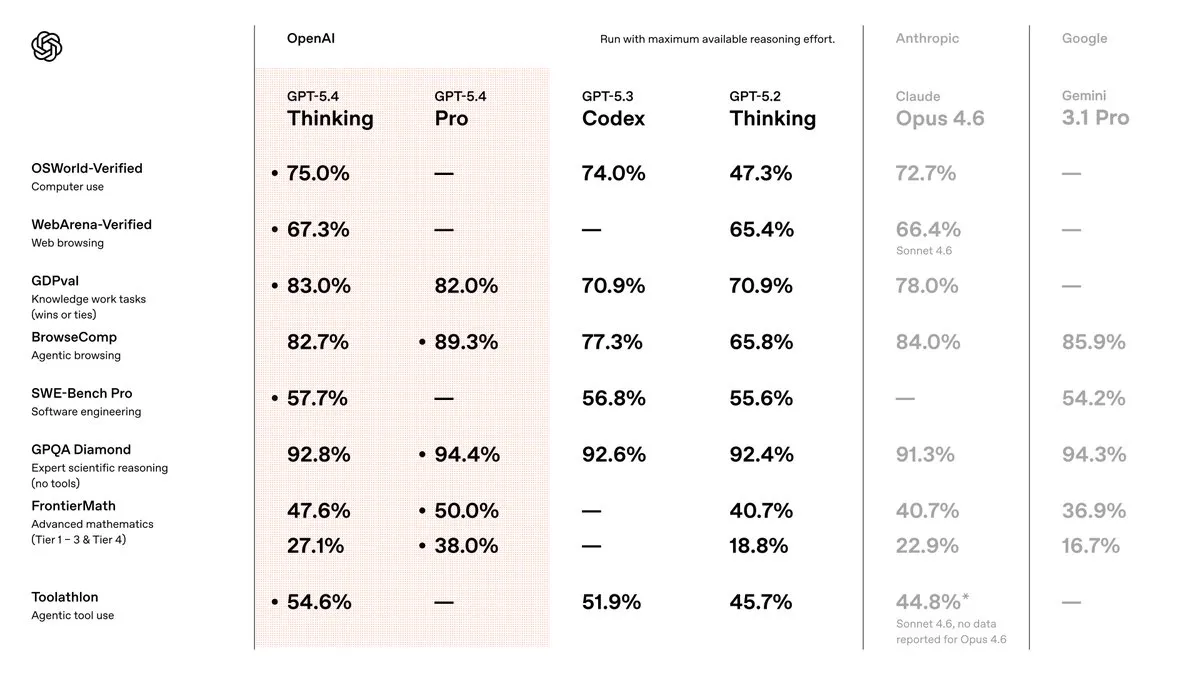
GPT 5.3 Codex 在编程场景中已经能与 Opus 4.6 打成平手,但在更通用的日常使用场景中仍然落后。 GPT 5.4 试图补齐这些短板,成为最值得使用的模型。除少数场景外,他们似乎做到了。
就纯粹的智能水平和完成任务的能力而言,GPT 5.4 是目前最强的模型。 它在推理、网页浏览、智能体应用和编程方面都很出色。 它的幻觉率也是目前所有模型中最低的。
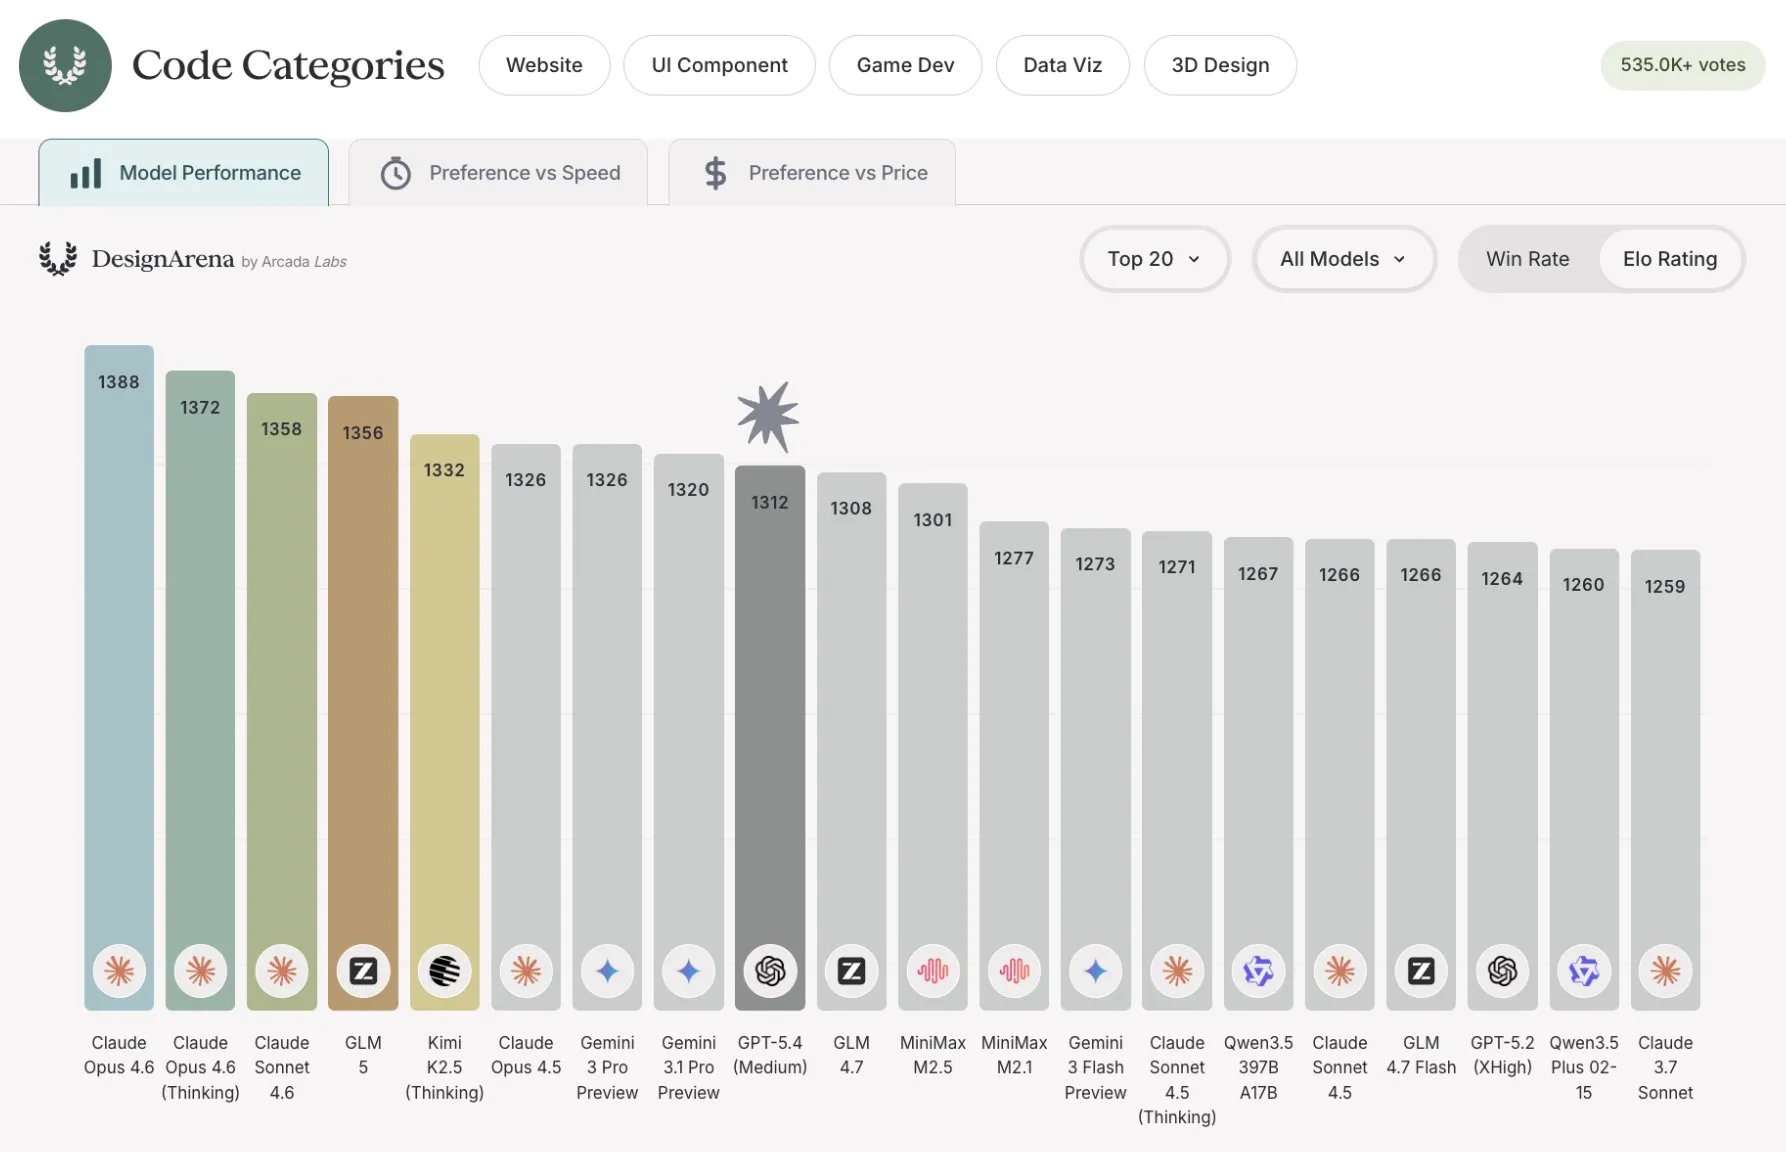
我们发现,它表现不佳的少数几个方面,依然是 GPT 一直以来的弱项,也是 Claude 的强项:个性、文风和设计。 这一点可以从 Design Arena 等基准测试中看出来:GPT 5.4 排名第 18,落后于 Claude、Gemini,甚至一些中国大语言模型。
它在某些方面也不如专注于编程的前代模型 GPT 5.3 Codex。 它的代码风格更好,对意图的理解也更强(不过在氛围编程方面仍然不如 Claude),但它似乎没有 5.3 那种对 bug 的“过敏体质”。
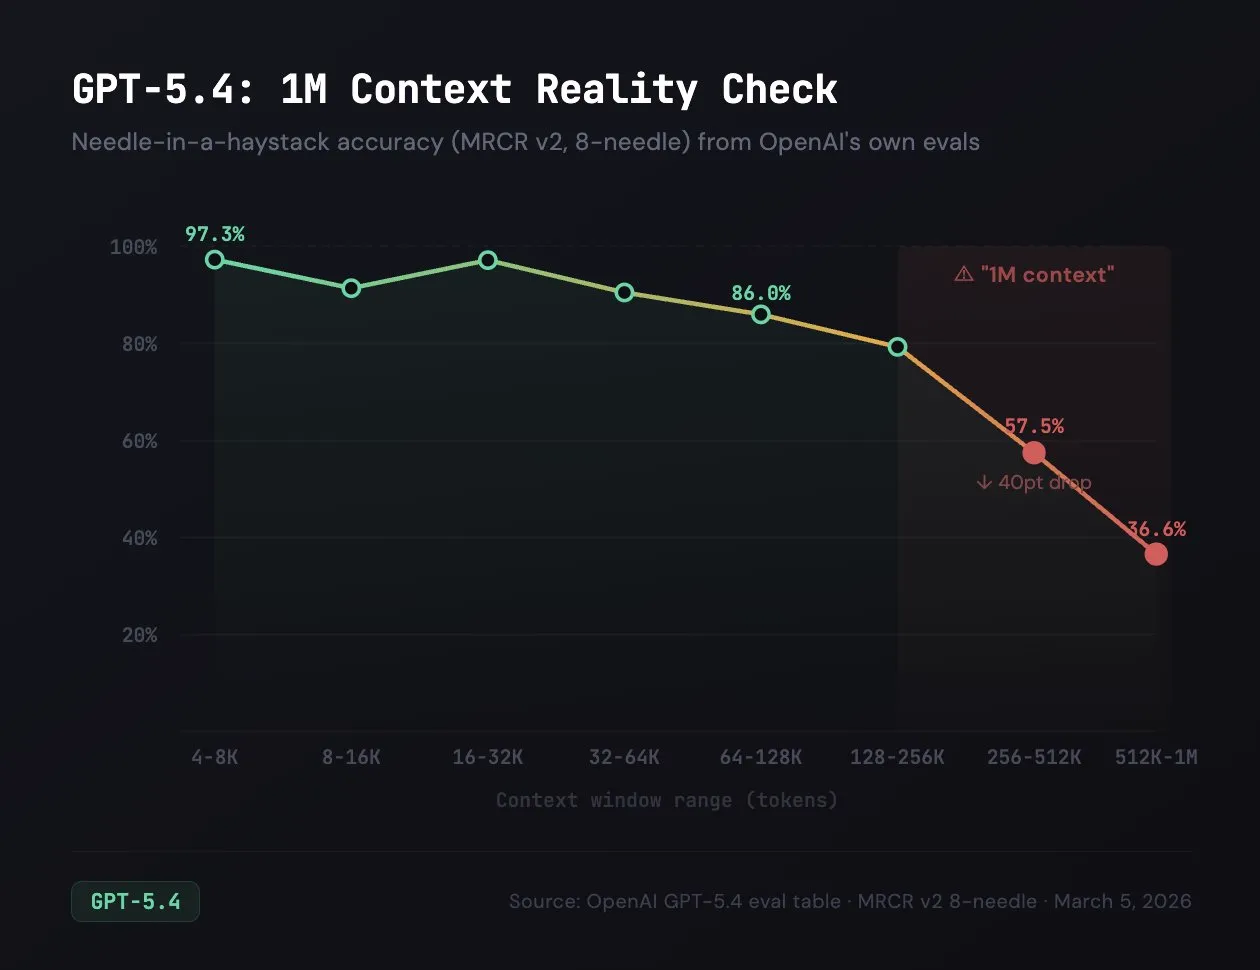
OpenAI 还将推出一个实验性的百万 token 上下文版本,可输入模型的 token 数量大约增加到原来的四倍。 不过,有这个功能并不代表它就好用,因为就连 OpenAI 自己的基准测试也显示,一旦超过 256k 的门槛,质量就会大幅下降。 因此,我建议避开百万上下文版本,尤其是超过 256k 的 token 还要按双倍价格收费。
说到定价,这也是此次发生变化的另一个方面。 由于“模型能力增强”,OpenAI 决定提高该模型的价格,类似于他们在 GPT 5.2 发布时的做法。
| 模型 | 每百万输入 token 价格(美元) | 每百万输出 token 价格(美元) | 每秒 token 数 |
|---|---|---|---|
| GPT 5.4 | $2.50 | $15 | 50 |
| GPT 5.2 | $1.75 | $14 | 46 |
| GPT 5 | $1.25 | $10 | 46 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| Gemini 3.1 Pro | $2 | $12 | 80 |
| Gemini 3 Flash | $0.50 | $3 | 80 |
| GLM 5 | $1 | $3.20 | 21 |
| MiniMax M2.5 | $0.30 | $1.20 | 27 |
这意味着,自最初的 GPT 5 发布以来,输入 token 的价格已经翻倍,输出价格也上涨了 50%。 它仍然比 Opus 便宜得多,但如今定价已接近 Sonnet,给了 Anthropic 更多竞争空间。
总体而言,GPT 5.4 是一个非常强大的模型。我强烈推荐大家试试用它处理日常任务、运行智能体以及编程。
Qwen 3.5 Small
Qwen 发布了全新 Qwen 3.5 系列中最后一档规模的模型,也就是 Qwen 3.5 小模型。 这次共有 4 款模型,参数规模分别为 0.8B、2B、4B 和 9B,全部采用常规的非混合专家架构。
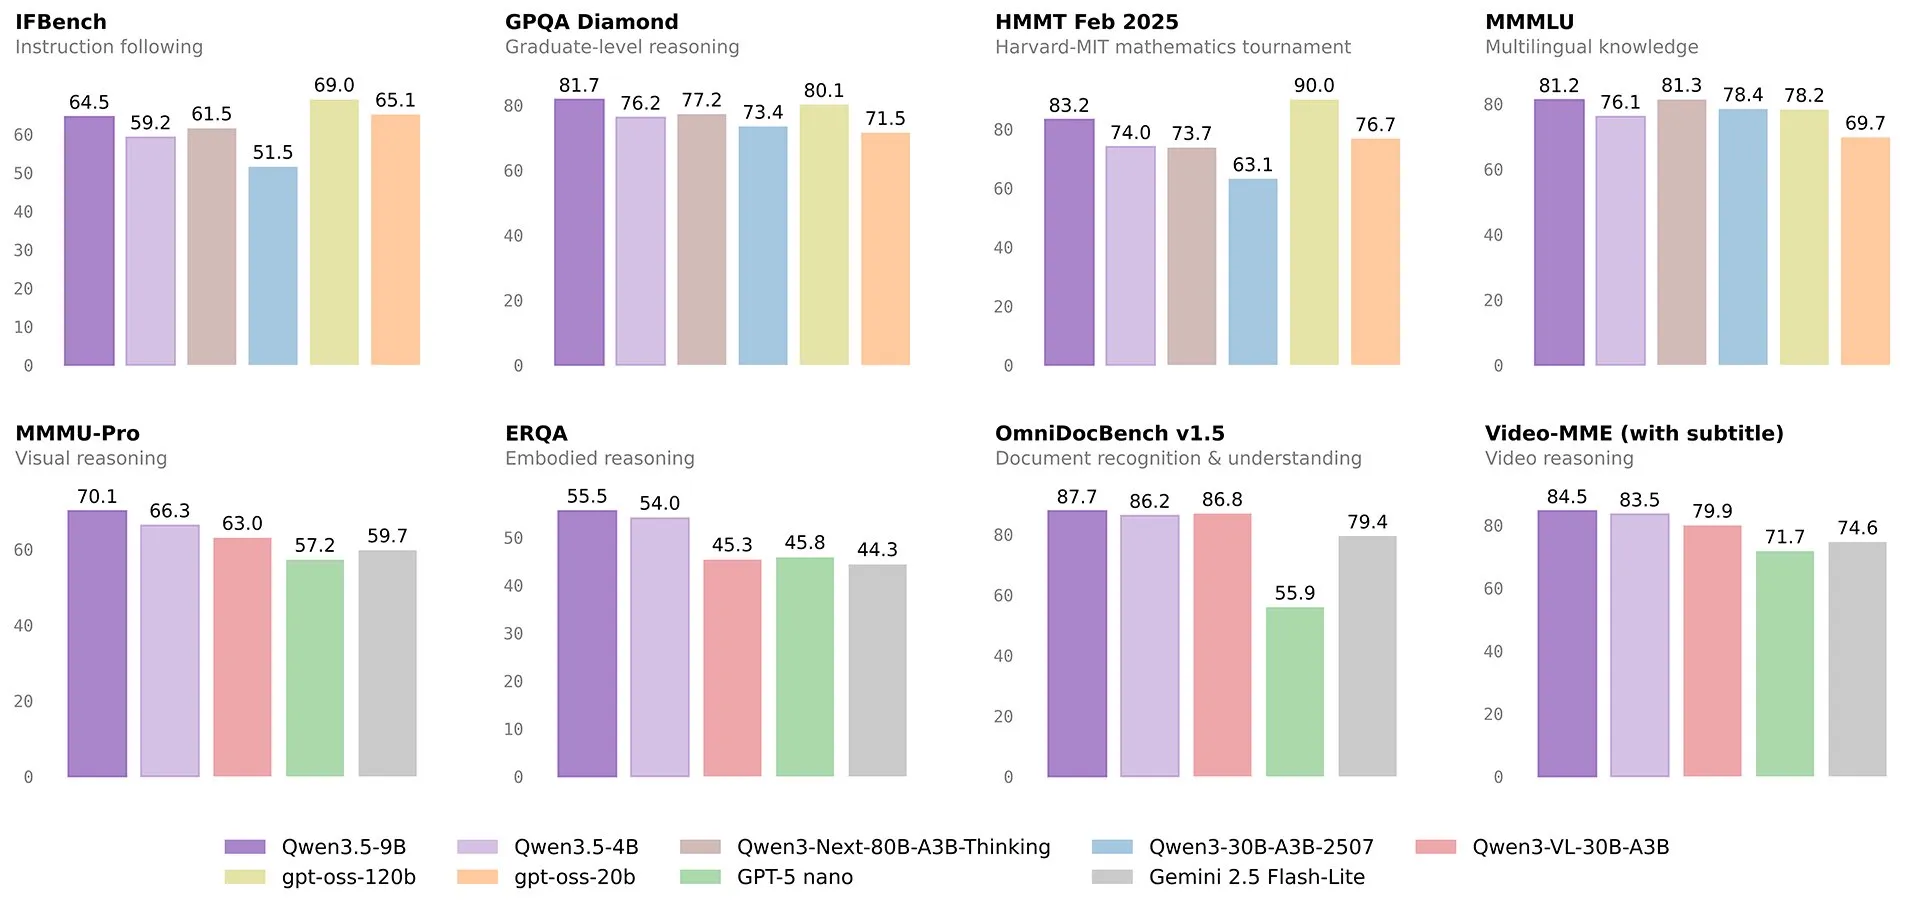
与 Qwen 3.5 系列的其他模型一样,它们都是混合推理模型(可以开启或关闭推理),也原生支持多模态输入。
人们一直在将它们与 GPT 4o 进行比较。GPT 4o 是一个参数量超过万亿、两年前处于顶尖水平的模型,而这些小模型在大多数智能基准测试中就是比它更强,智能体能力也远胜于它。
不过,略显尴尬的是,它们实际上并不是目前最强的小模型。 这一头衔仍然属于 Nanbeige。在过去两周才发布的基准测试中(模型无法对尚未发布的基准测试过拟合),它轻松击败了全新的 Qwen 4B 和 9B 模型,而它自身只有 3B 参数。
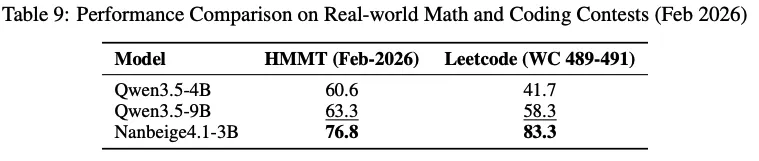
这并不是说 Qwen 模型没有用。 NanBeige 即使面对简单问题,也往往要思考很久才会回答(而且无法关闭推理),同时也不支持多模态。
所以,如果你喜欢在家里(或手机上)运行模型,我仍然建议你试试这些新的 Qwen 3.5 小模型。
快讯
GPT 5.3 Instant
令人费解的是,OpenAI 本周同时发布了 GPT 5.4 和 5.3。
这是因为后者是他们的即时模型,主要面向 ChatGPT 免费版用户。 它是 GPT 5 家族中的非推理模型(此前称为最低限度推理),一直以来都远不如那些善于深思的兄弟模型。
我认为,通过这次发布,OpenAI 想表明,这个模型与 GPT 5.4 完全独立,并不只是推理等级更低,而是一个完全不同的、更小的模型。
这个模型没什么值得称道的。每当你看到 ChatGPT 犯傻,通常都是即时模型在作答。 这次更新似乎略微改善了模型的个性和文风,他们还声称降低了模型的幻觉率(但没有基准测试来支持这一说法)。
而在他们确实公布的基准测试中,相较于此前版本,模型的表现几乎没有变化。
因此,我强烈建议你尽可能使用 GPT 5.4,除了最简单的问题,尽量避开即时模型。
结语
希望你喜欢本周的新闻。如果想每周都收到这些资讯,记得在下方订阅我们的邮件列表。