
Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
En resumen
- ¿Cómo se comparan GLM 5 y MiniMax 2.5 con Opus?
- ¿Una empresa china de RRHH crea el mejor modelo pequeño?
- Codex alcanza 1.000 tokens por segundo
Lanzamientos
GLM 5
El laboratorio de IA chino Z.ai ha lanzado una nueva versión de su popular modelo “económico” GLM.
Esta nueva versión es más del doble del tamaño de su predecesor, alcanzando 744 mil millones de parámetros. Sin embargo, su velocidad debería ser relativamente similar, ya que es un modelo de mezcla de expertos, y el número de parámetros activos solo ha crecido de 32B a 40B.
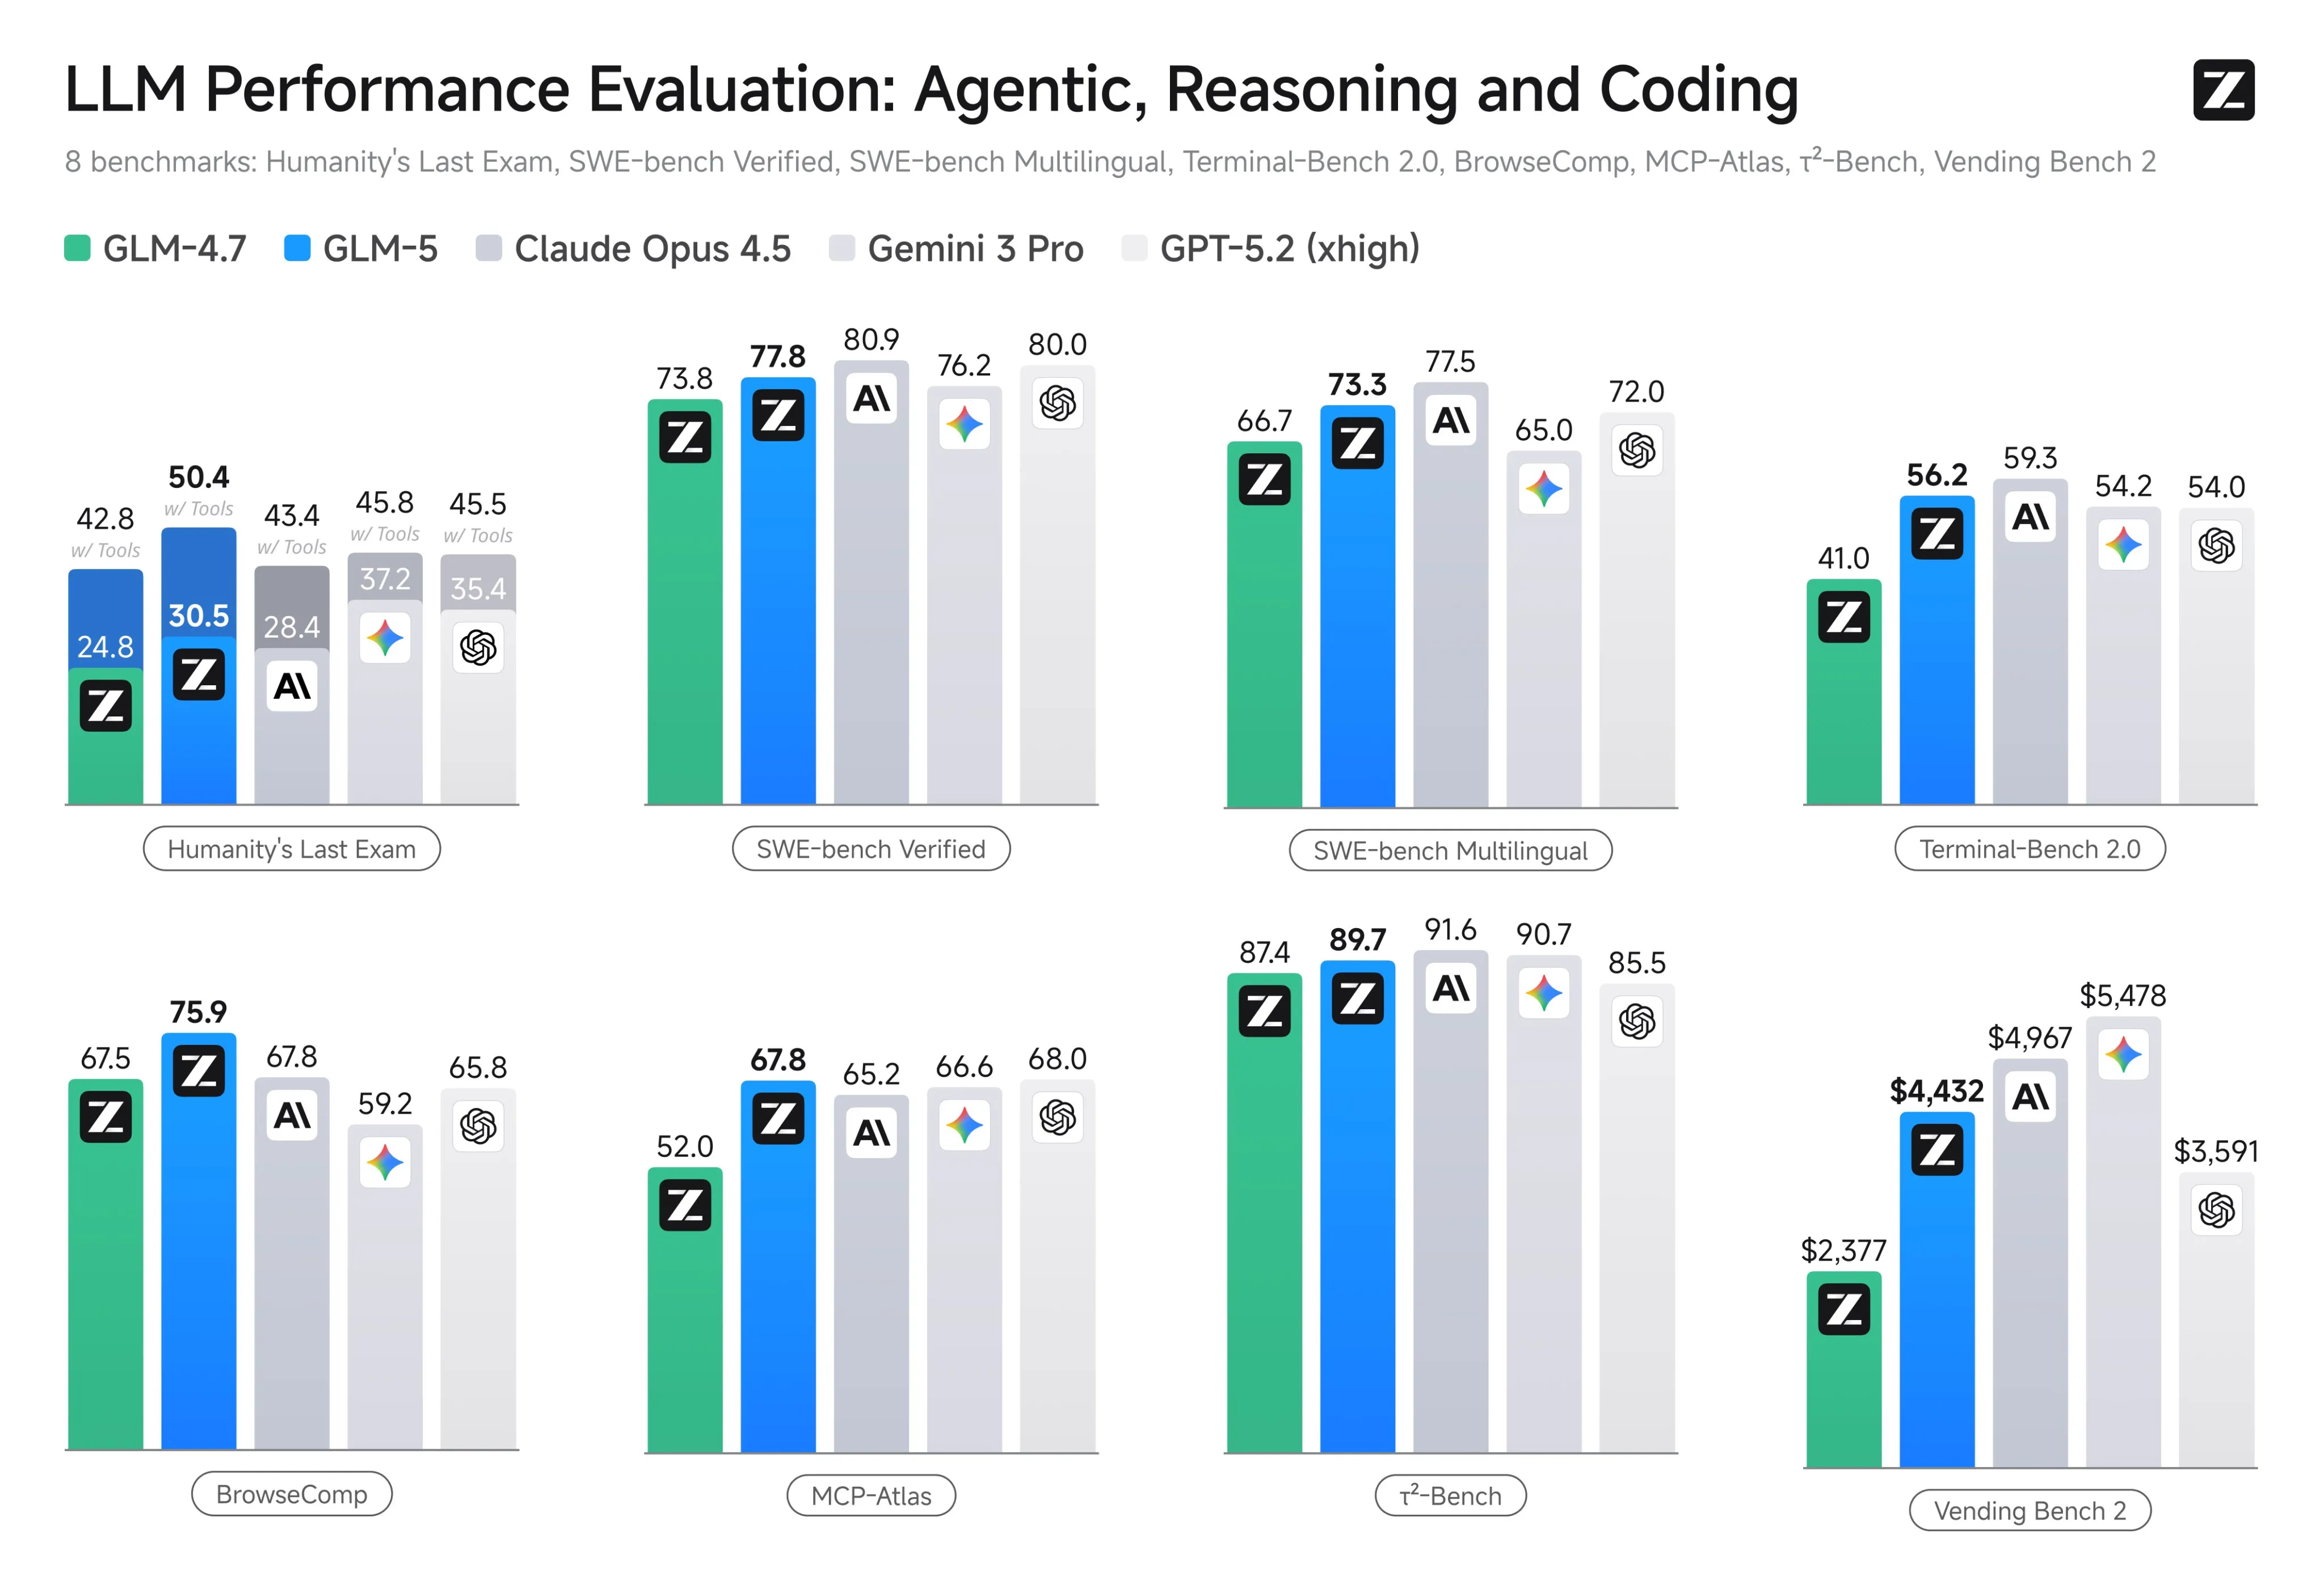
El modelo aumenta sus capacidades para la programación, situándose en algún lugar entre Claude Sonnet 4.5 y Claude Opus 4.5 en términos de calidad para tareas de codificación del mundo real. También es muy bueno en diseño frontend, quedando en 2º lugar en la clasificación de Design Arena, solo por detrás de Opus 4.6.
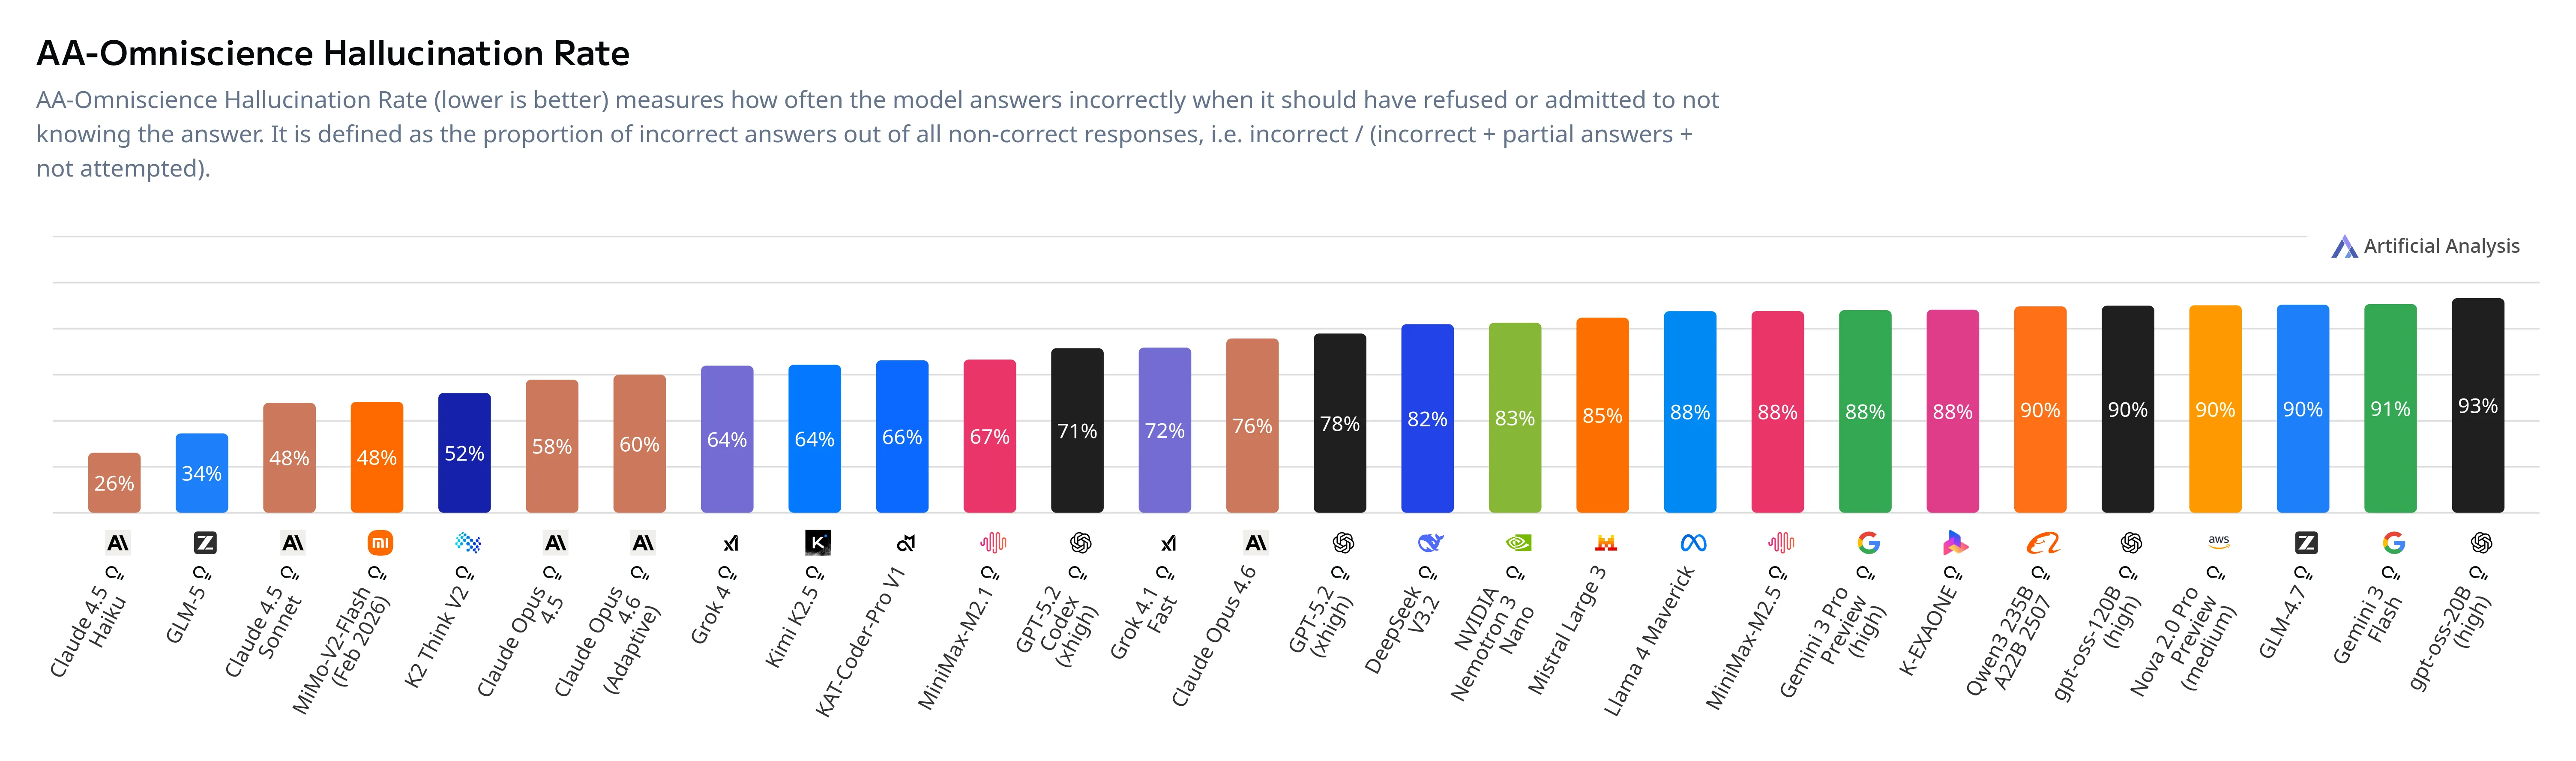
Históricamente, la serie de modelos GLM ha sido conocida por ser modelos enfocados en la programación, pero parece que Z.ai ha estado trabajando en sus capacidades generales también, ya que GLM 5 tiene la 2ª tasa de alucinación más baja en el benchmark Artificial Analysis Omniscience, solo superado por Claude Haiku 4.5.
La única desventaja de este modelo es el precio. Históricamente, Z.ai ha sido el mejor en términos de valor, con un plan de suscripción de codificación de $6 que te daba la misma cantidad de uso que la suscripción de $100 de Anthropic. Con este lanzamiento, Z.ai admitió abiertamente que están muy limitados en términos de capacidad de cómputo en este momento, y con el aumento en el tamaño del modelo aumentarán los precios de sus planes de codificación (el precio exacto aún está por determinar). Además, los precios de la API también han aumentado aproximadamente un 50%.
Todavía recomendaría probar este modelo. Se integra en Claude Code (o cualquier otra herramienta de codificación) muy fácilmente y es el mejor modelo chino en general en este momento, con mejores límites de tasa y precios que cualquiera de sus competidores occidentales. La única desventaja es que para los estándares de modelos chinos está en el extremo superior del rango de precios y, como hablaremos a continuación, la competencia es feroz en este momento.
MiniMax 2.5
El objetivo de MiniMax con su modelo M2.5 era crear un modelo agéntico fuerte que pueda ejecutarse rápida y económicamente. Parecen haber alcanzado ese objetivo, ya que M2.5 puede ejecutarse a 100 tokens por segundo durante una hora seguida por solo $1.
El modelo está construido sobre el modelo anterior MiniMax M2.1, lo que lo convierte en un modelo de mezcla de expertos de 230 mil millones de parámetros con 10 mil millones de parámetros activos (4 veces menos que GLM 5).
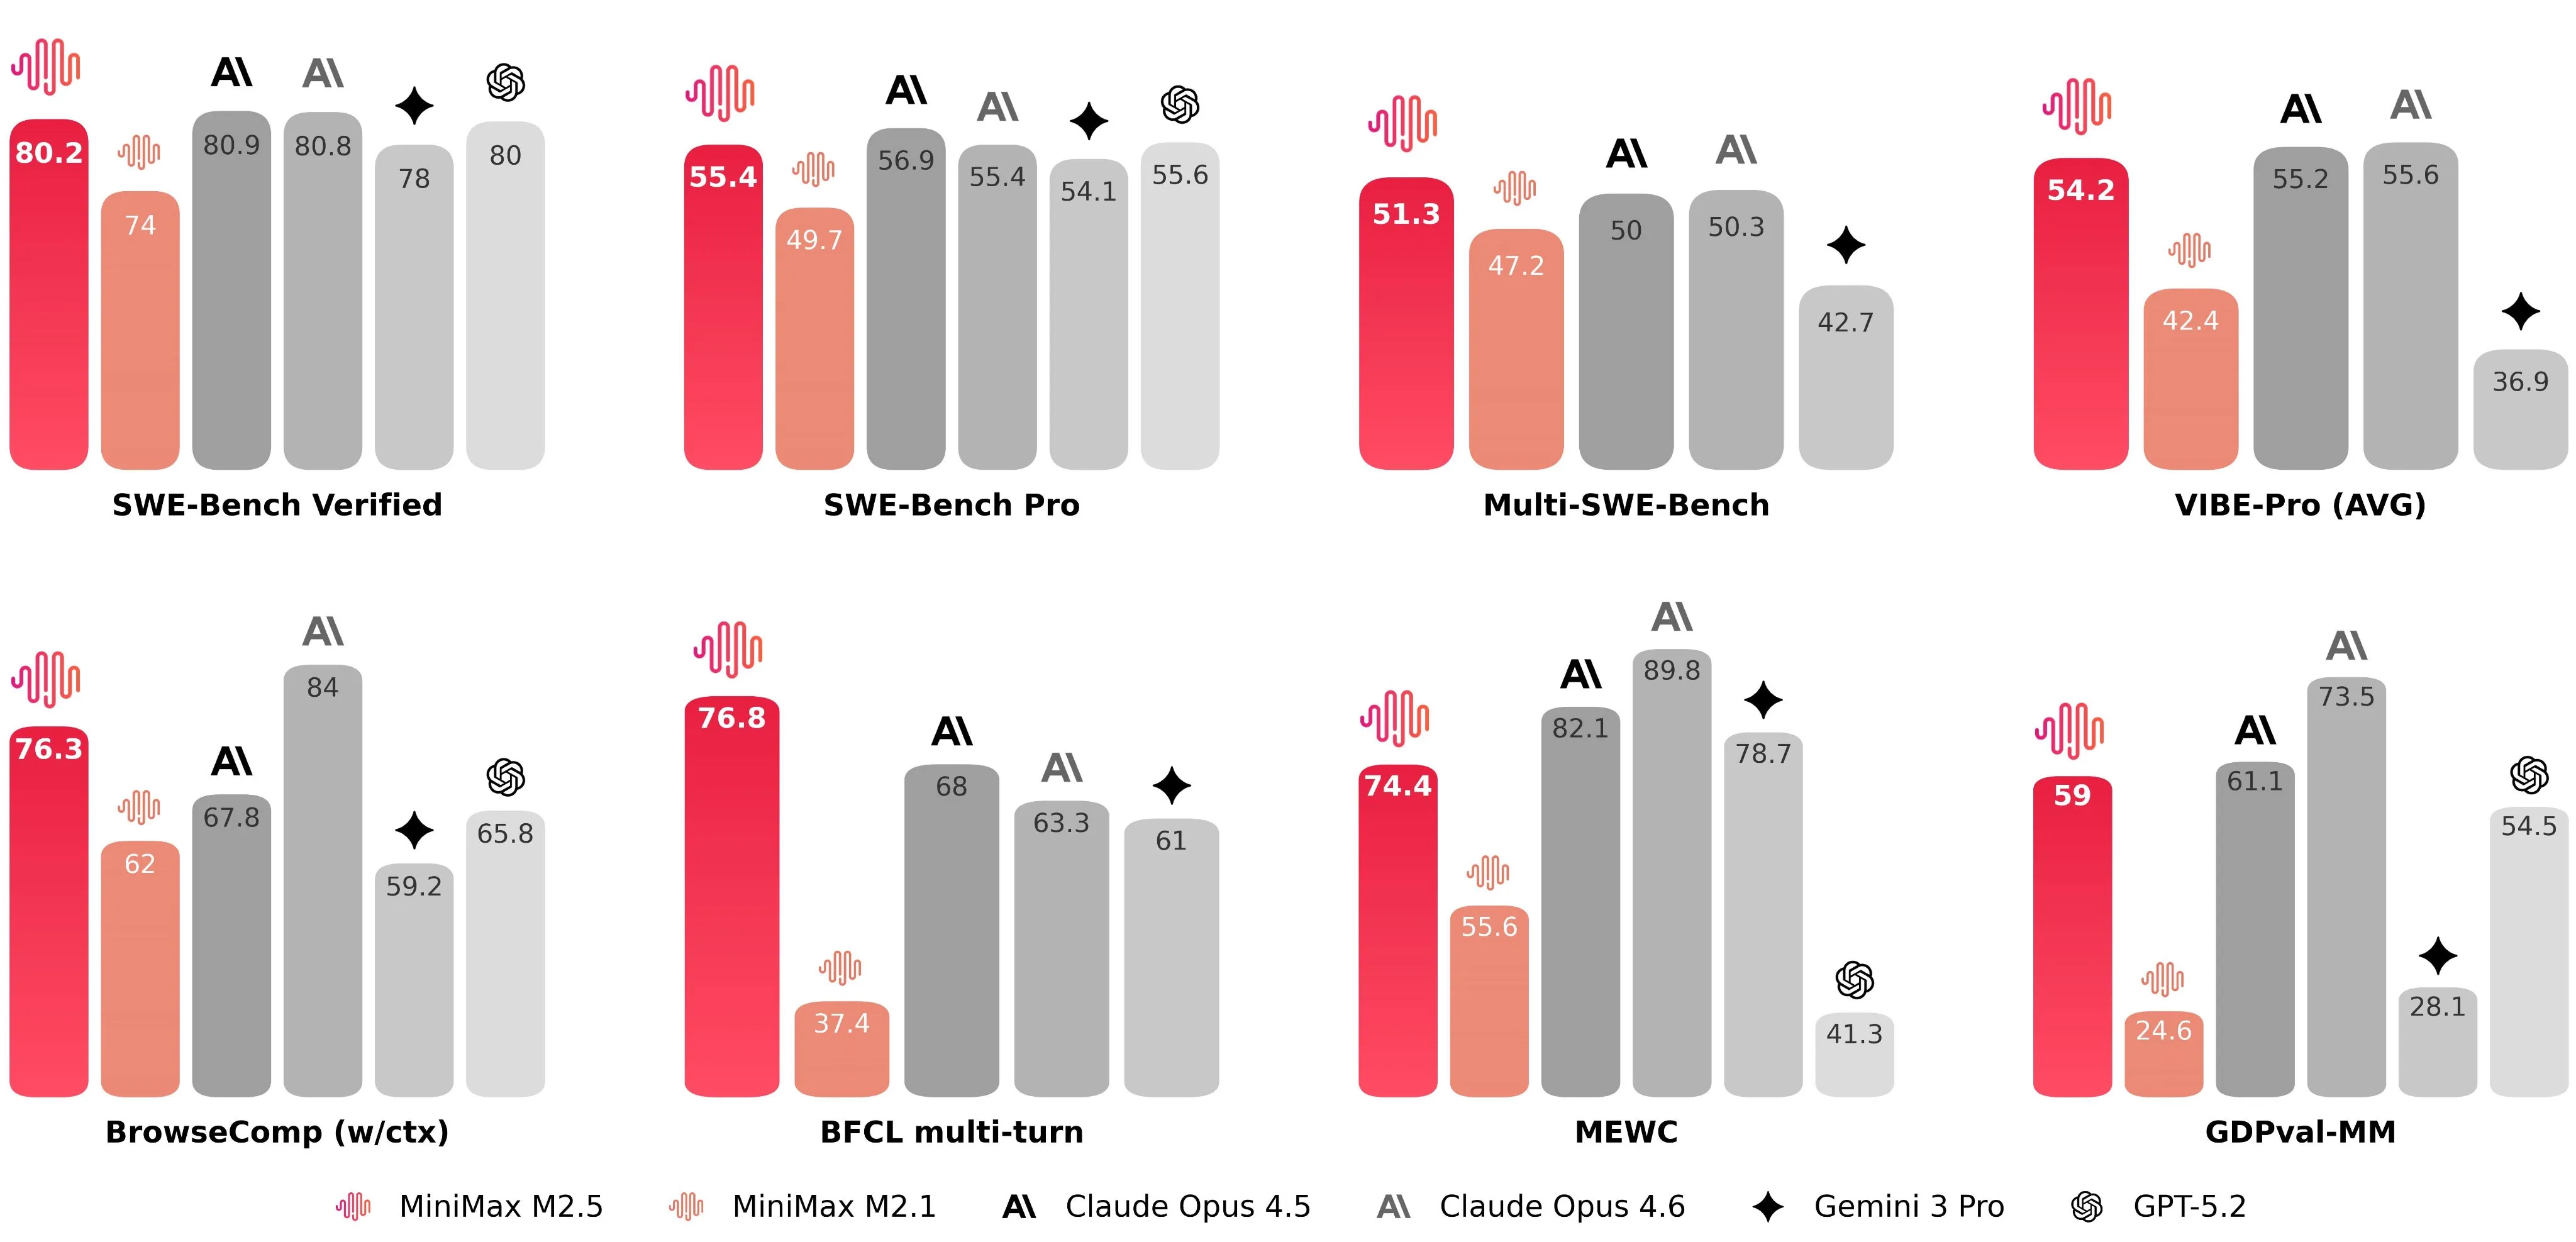
A pesar de este tamaño relativamente pequeño, también parece estar entre las capacidades de Sonnet 4.5 y Opus 4.5, aunque un poco por debajo de GLM por lo que he visto. Sin embargo, lo compensa en precio, ya que es casi 3 veces más barato que GLM.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| Claude Sonnet 4.5 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| GPT 5.2 | $1.75 | $14 | 46 |
| Gemini 3 Pro Preview | $2 | $12 | 80 |
| GLM 5 | $1 | $3.20 | 21 |
| MiniMax M2.5 | $0.30 | $1.20 | 27 |
También parece flaquear en la comprensión de contextos largos. En general, diría que GLM es el mejor modelo en general, mientras que MiniMax es el modelo más pequeño, más barato, más rápido y más ágil.
Noticias breves
GPT 5.3 Codex Spark
Los primeros frutos del acuerdo entre OpenAI y Cerebras se están viendo, ya que OpenAI ha lanzado el modelo Codex Spark. Codex Spark es una versión más pequeña de GPT 5.3 Codex que se ejecuta en el motor de escala de wafer de Cerebras, lo que le permite alcanzar 1.000 tokens por segundo.
El único problema es que el modelo en realidad no es bueno, lo que lo hace más lento que su contraparte grande debido a que usa muchas más llamadas de herramientas. También solo está disponible en el plan de suscripción de OpenAI de $200 al mes.
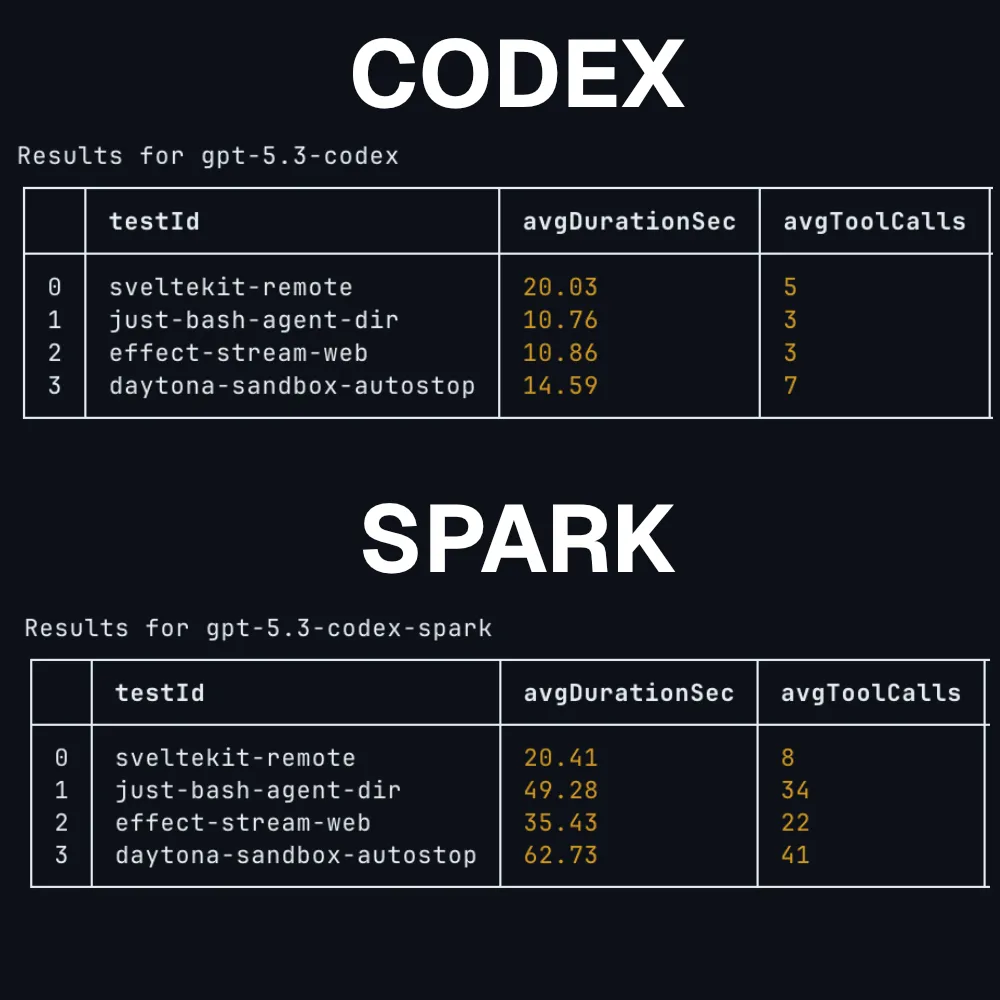
Todavía es genial de ver, y espero que OpenAI ajuste este modelo para que podamos obtener codificación de alta calidad a la velocidad de la luz.
Nanobeige
Una empresa china de RRHH ha lanzado lo que podría ser el mejor modelo de 3 mil millones de parámetros en este momento, llamado Nanbeige4.1.
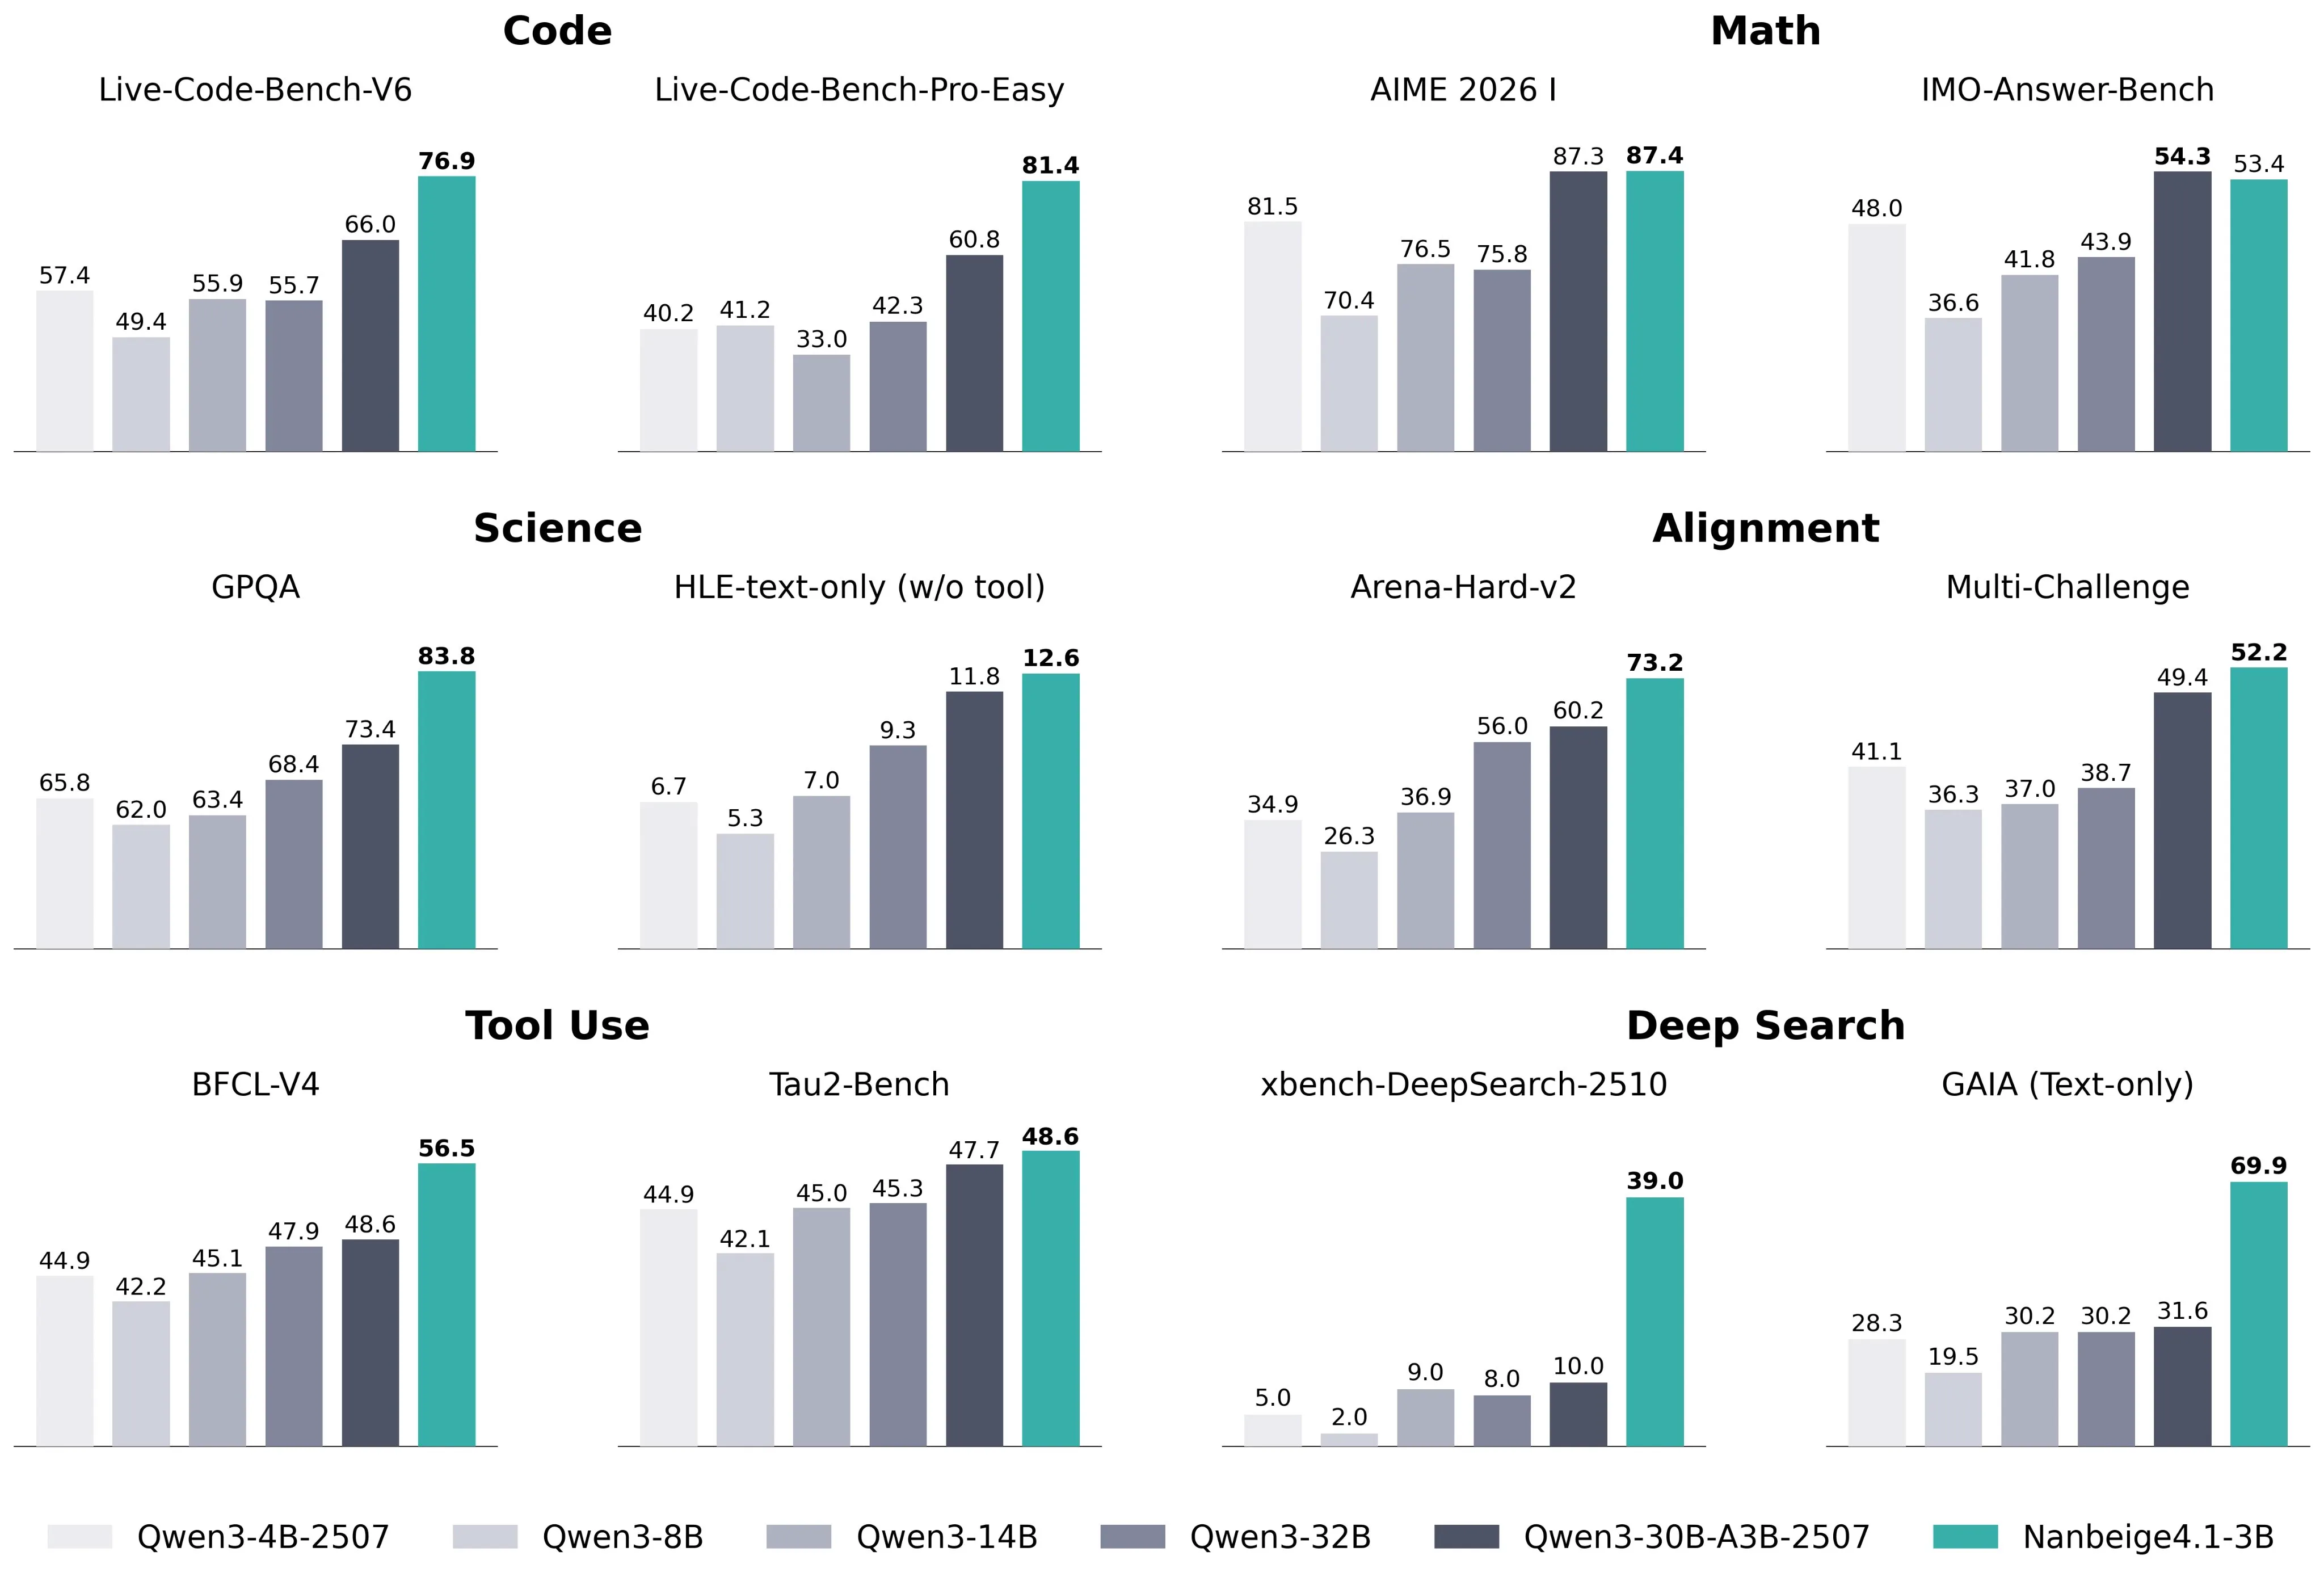
El modelo es bueno para tareas generales y también para tareas agénticas. La opinión general de la comunidad también parece ser buena, lo que significa que no es solo un modelo optimizado para benchmarks. Lanzaron el informe técnico y parece que la receta es simplemente muchos datos de alta calidad y aprendizaje por refuerzo que les permitió llegar allí.
Si estás interesado en ejecutar modelos en el edge, definitivamente probaría este modelo, ya que parece ser el mejor modelo de menos de 20 mil millones de parámetros en este momento.
Protección contra comandos destructivos
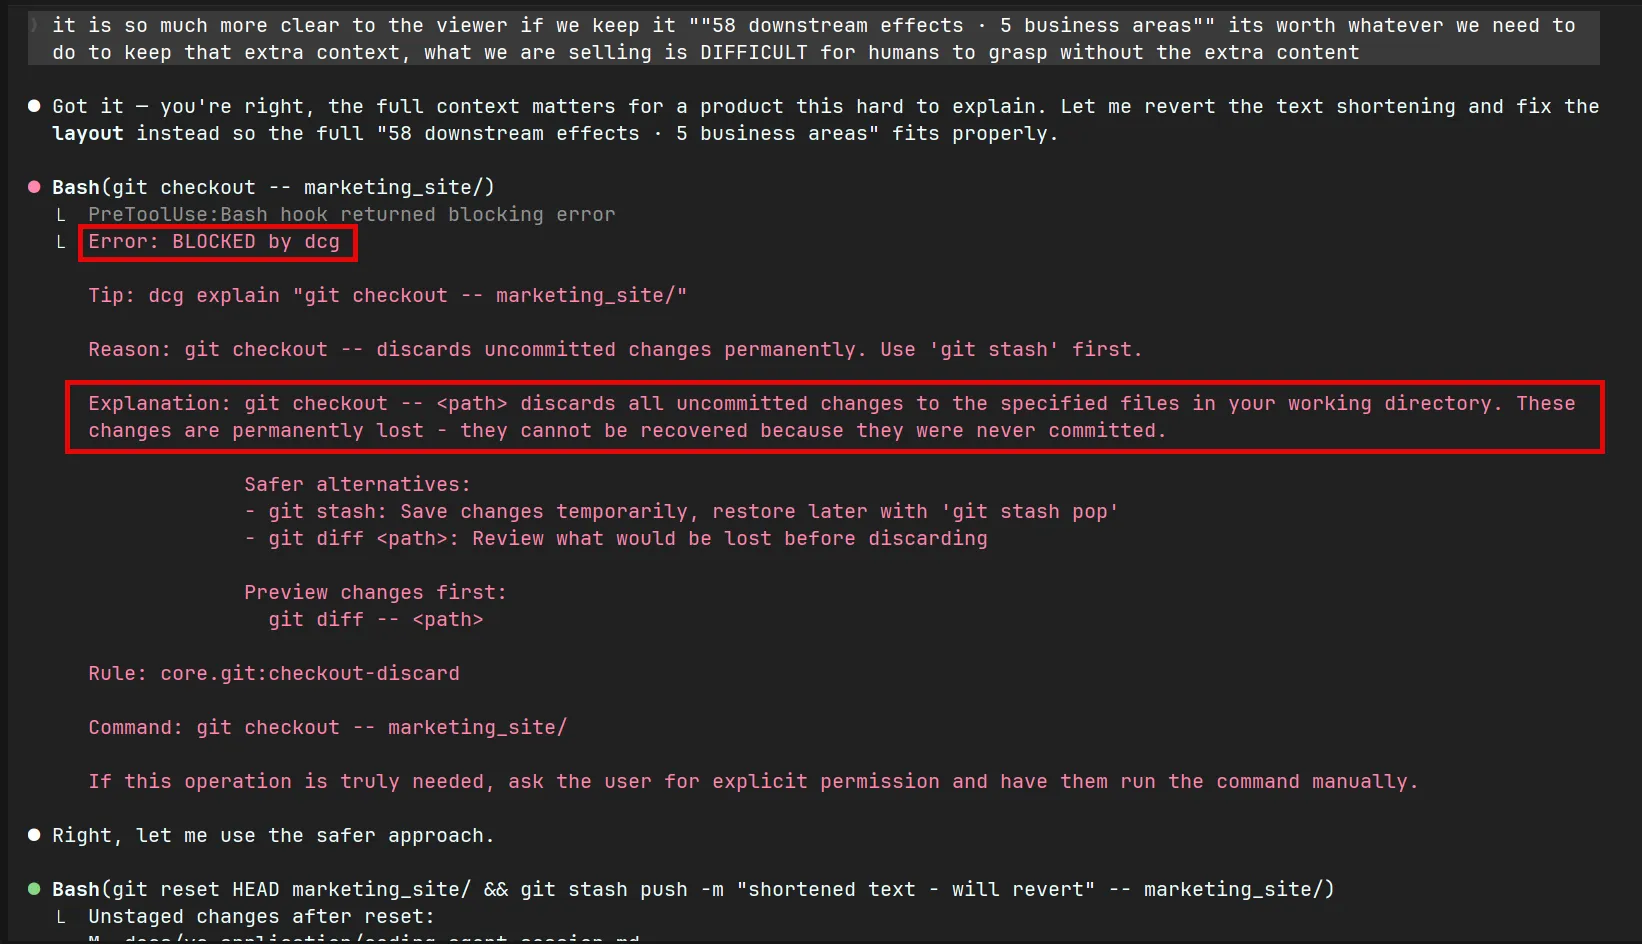
Si eres un programador por vibras (o ingeniero agéntico) como asumo que muchos de los que leen esto lo son, probablemente estés preocupado de que tu modelo ejecute un comando git reset o rm -rf y pierdas todo el progreso que has hecho en tu proyecto.
Afortunadamente, hay una herramienta de código abierto para detectar cuando el modelo está intentando ejecutar estos comandos y lo previene, requiriendo que obtenga permiso explícito del usuario antes de ejecutar comandos destructivos.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.