
Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
GLM 5
O laboratório chinês de IA Z.ai lançou uma nova versão de seu popular modelo “econômico” GLM.
Esta nova versão é mais do que o dobro do tamanho de seu predecessor, atingindo 744 bilhões de parâmetros. No entanto, sua velocidade deve ser relativamente similar, já que é um modelo de mistura de especialistas, e o número de parâmetros ativos cresceu apenas de 32B para 40B.
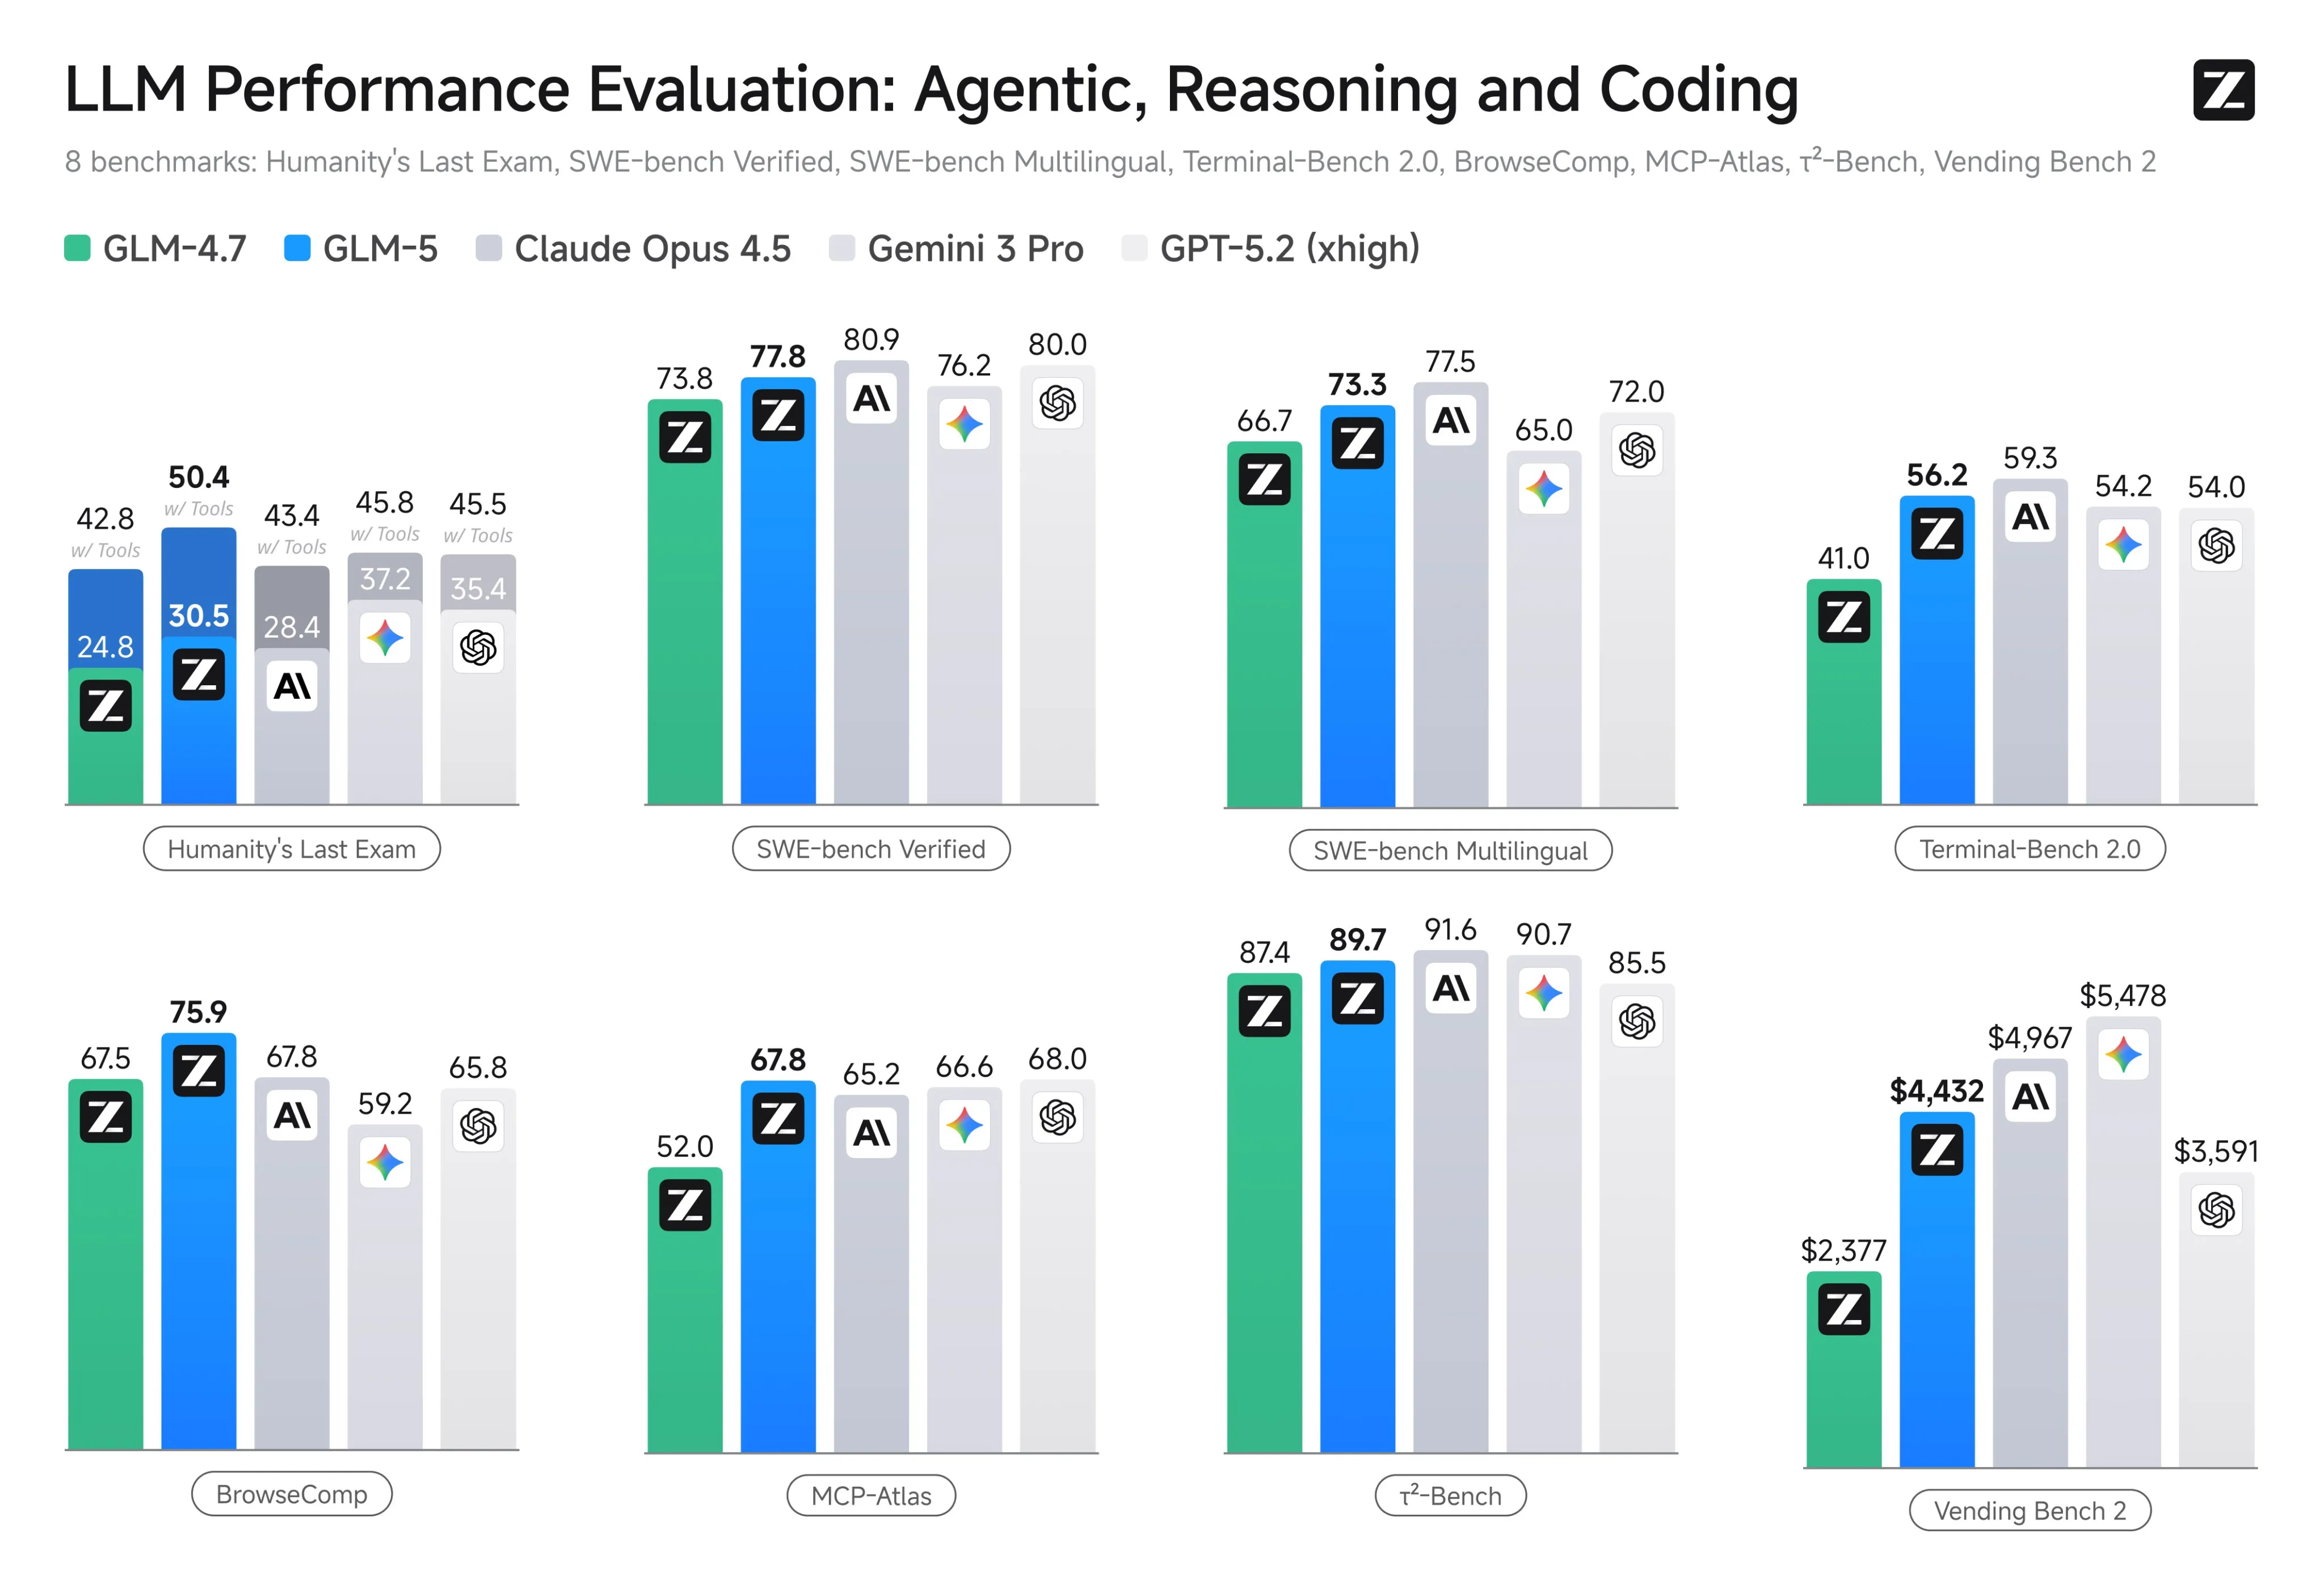
O modelo aumenta suas capacidades para codificação, posicionando-se em algum lugar entre Claude Sonnet 4.5 e Claude Opus 4.5 em termos de qualidade para tarefas de codificação do mundo real. Também é muito bom em design frontend, ficando em 2º lugar no ranking do Design Arena, apenas atrás do Opus 4.6.
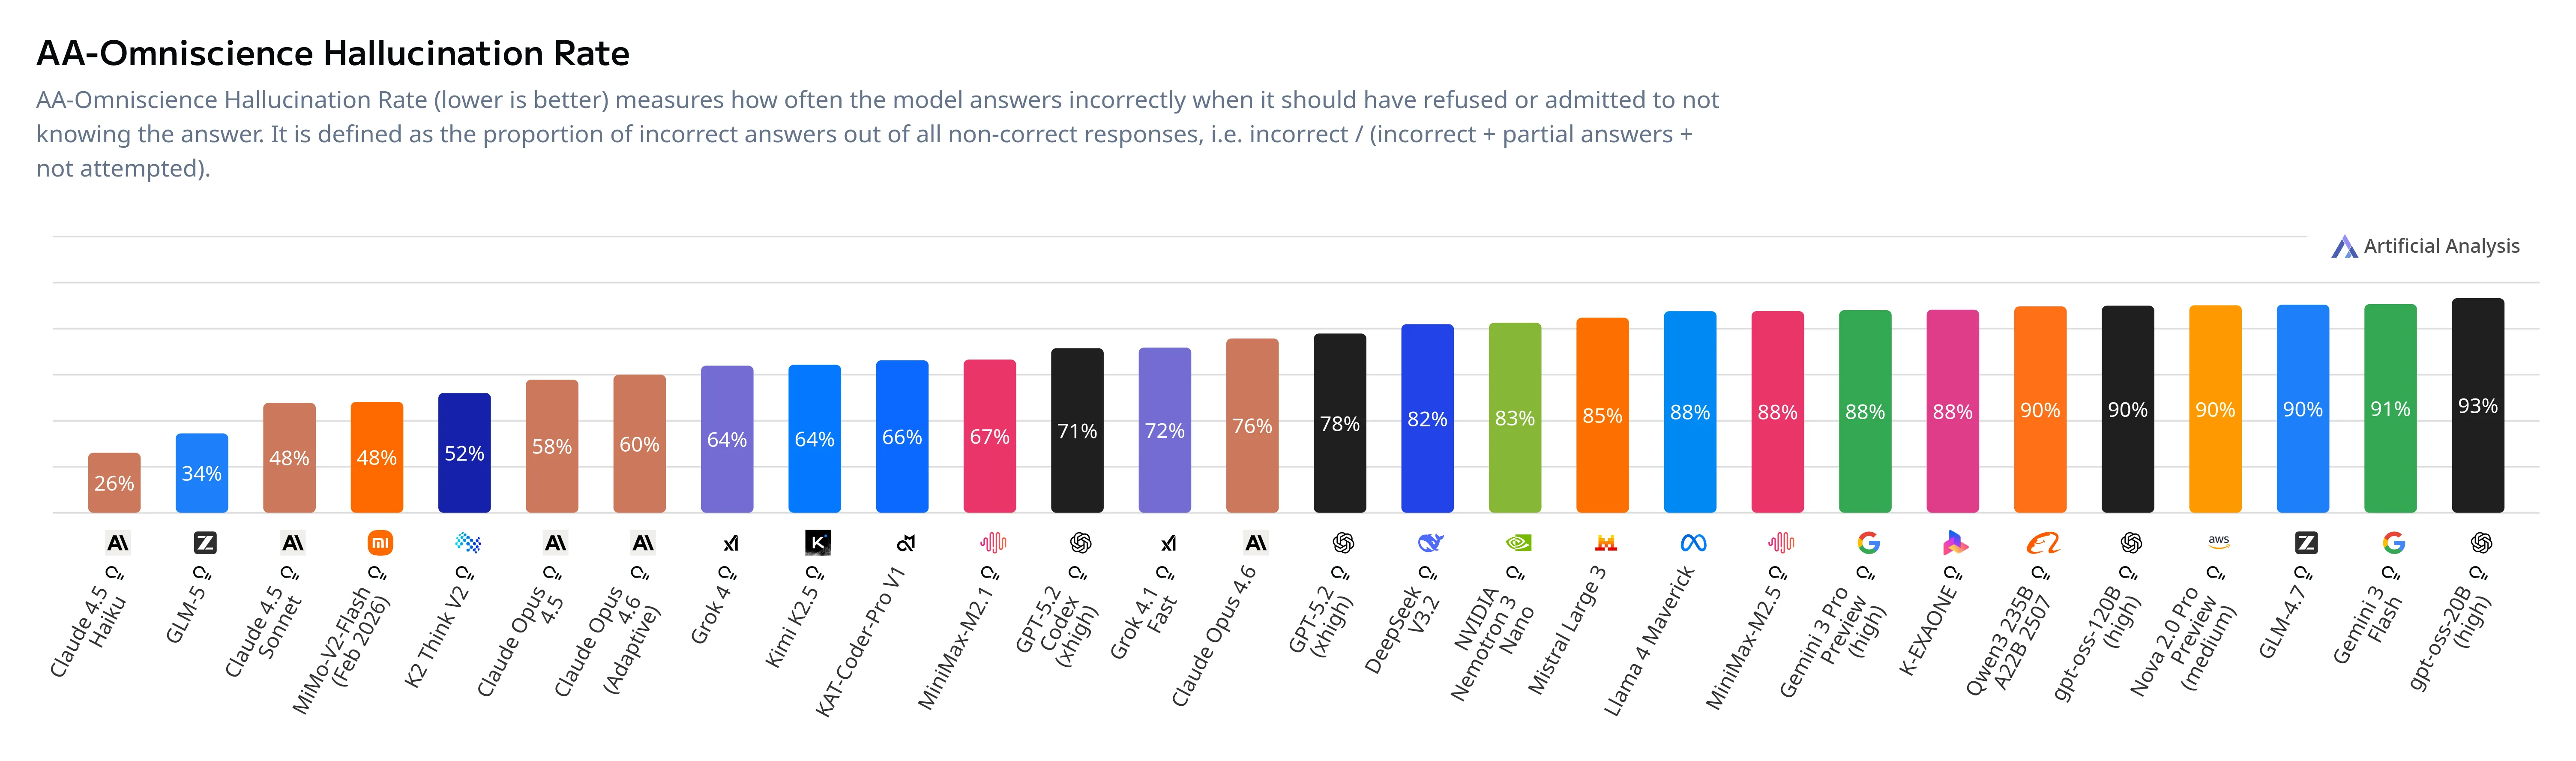
Historicamente, a série de modelos GLM tem sido conhecida como modelos focados em codificação, mas parece que a Z.ai tem trabalhado em suas capacidades gerais também, já que o GLM 5 tem a 2ª menor taxa de alucinação no benchmark Artificial Analysis Omniscience, sendo superado apenas pelo Claude Haiku 4.5.
A única desvantagem deste modelo é o preço. Historicamente, a Z.ai tem sido a melhor em termos de valor, com um plano de assinatura de codificação de $6 que oferecia a mesma quantidade de uso que a assinatura de $100 da Anthropic. Com este lançamento, a Z.ai admitiu abertamente que está fortemente limitada em capacidade computacional no momento, e com o aumento no tamanho do modelo, aumentarão os preços de seus planos de codificação (preço exato ainda a ser definido). Além disso, o preço da API aumentou cerca de 50% também.
Eu ainda recomendaria experimentar este modelo. Ele se integra ao Claude Code (ou qualquer outra ferramenta de codificação) muito facilmente e é o melhor modelo chinês geral no momento, com limites de taxa e preços muito melhores do que qualquer um de seus concorrentes ocidentais. A única desvantagem é que para os padrões de modelos chineses, está na faixa alta de preço e, como falaremos a seguir, a concorrência está acirrada agora.
MiniMax 2.5
O objetivo da MiniMax com seu modelo M2.5 era criar um modelo agêntico forte que pudesse ser executado de forma rápida e barata. Eles parecem ter alcançado esse objetivo, já que o M2.5 pode ser executado a 100 tokens por segundo por uma hora seguida por apenas $1.
O modelo é construído sobre o modelo MiniMax M2.1 anterior, tornando-o um modelo de mistura de especialistas de 230 bilhões de parâmetros com 10 bilhões de parâmetros ativos (4x menos que o GLM 5).
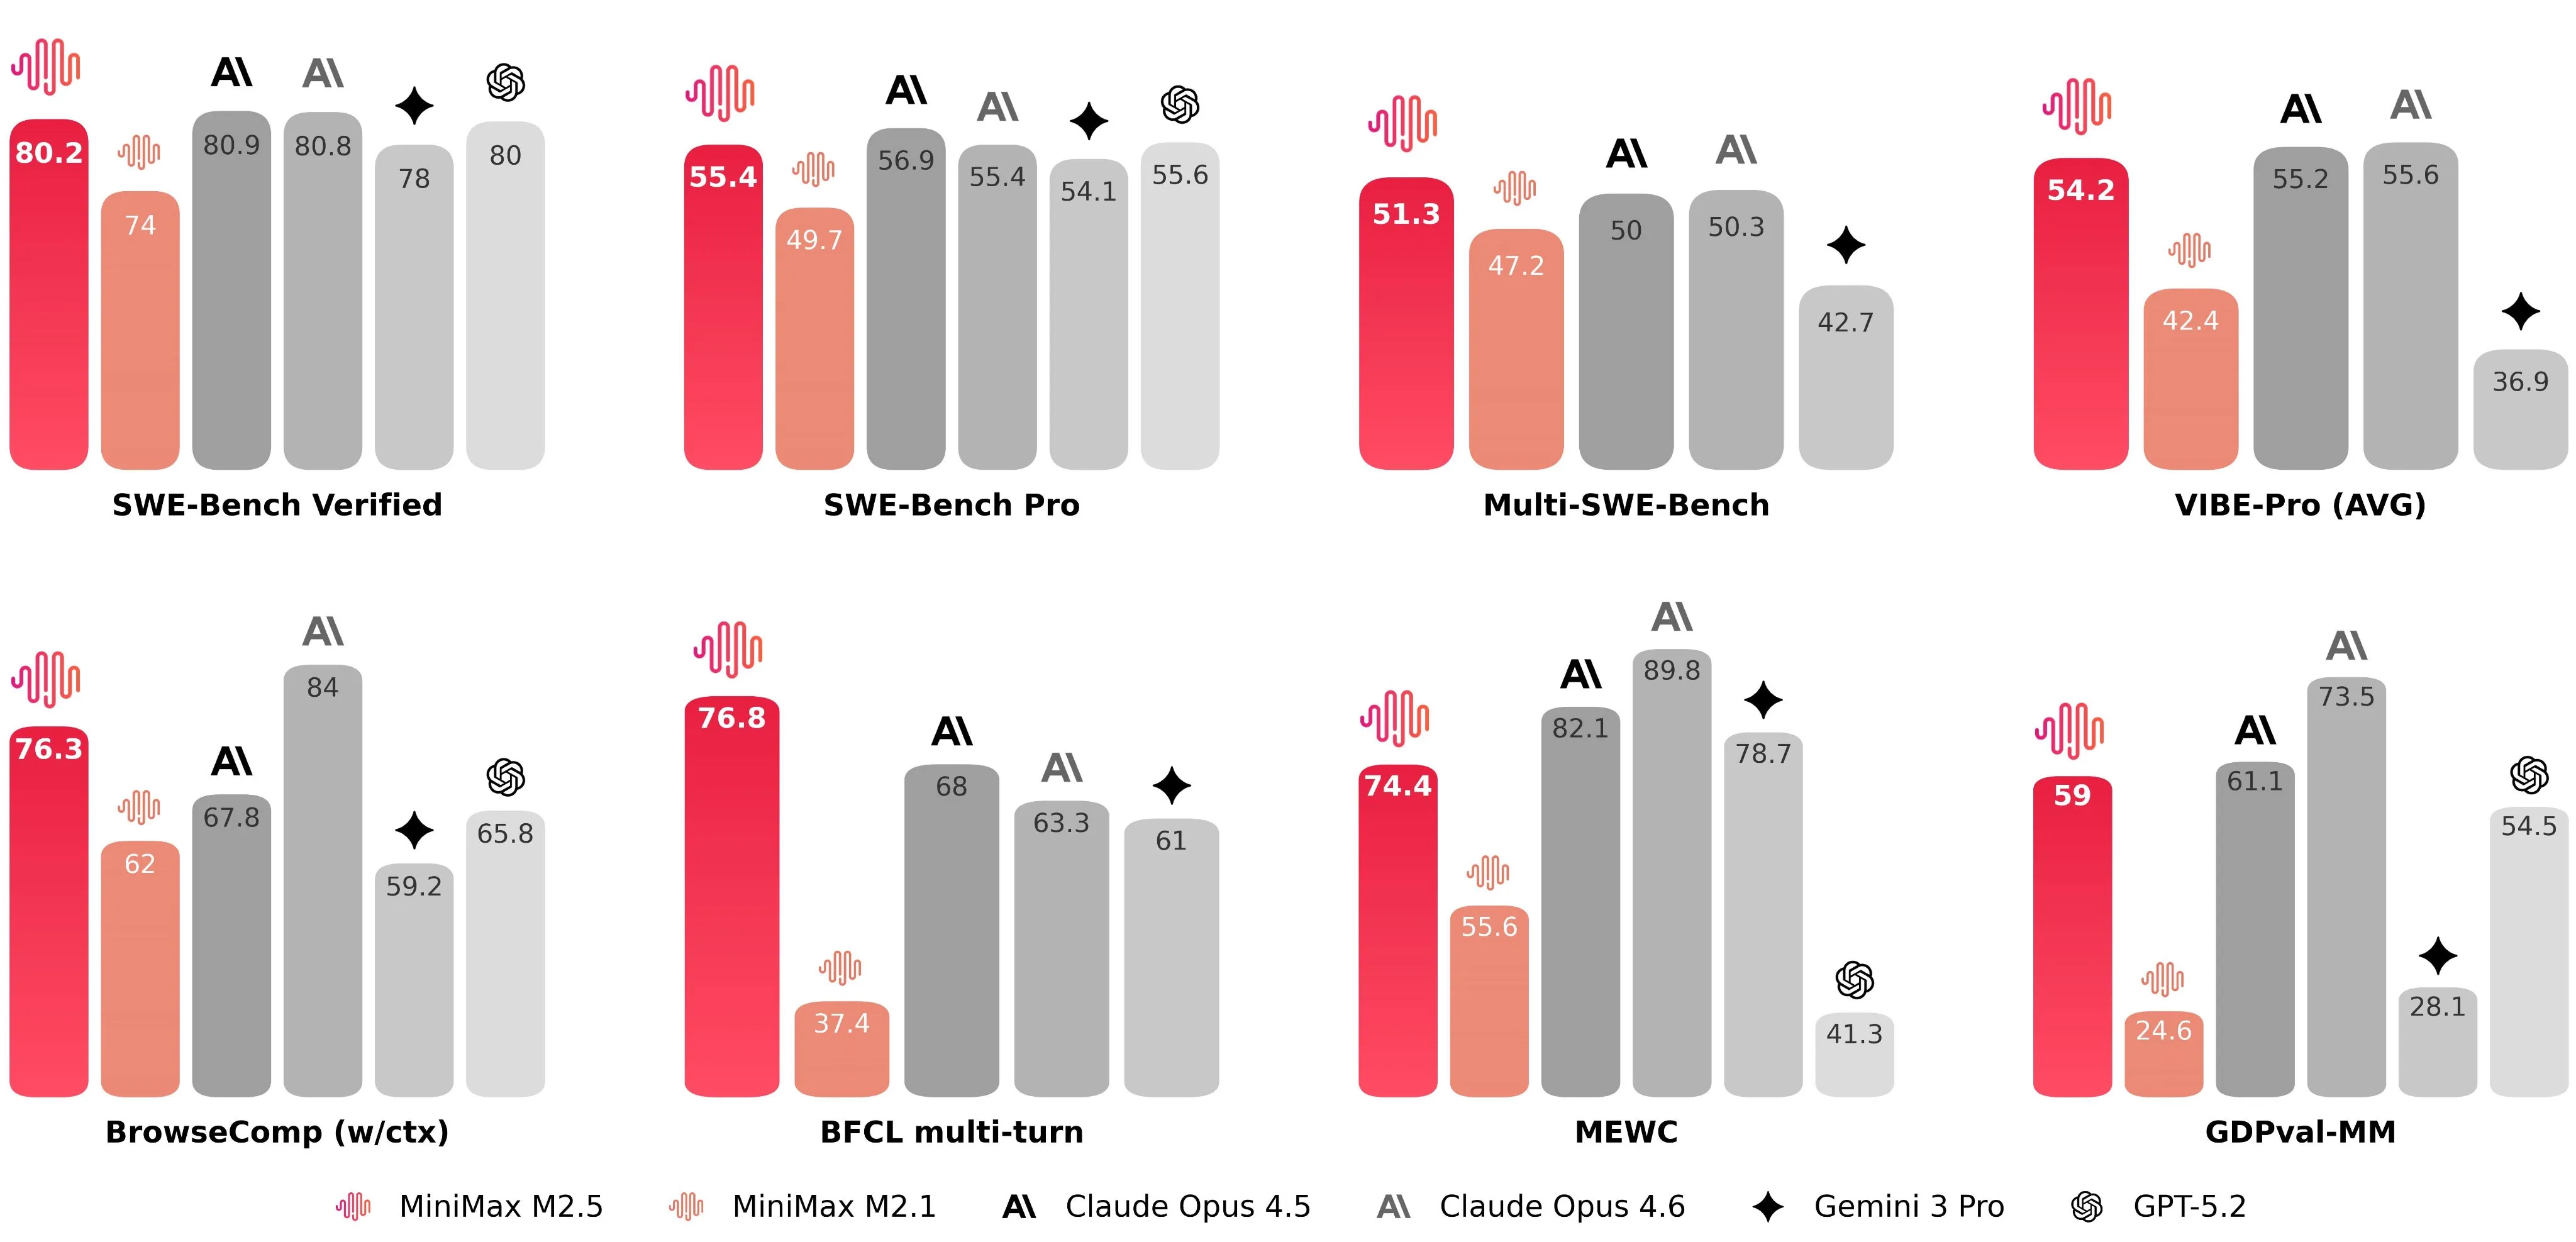
Apesar deste tamanho relativamente pequeno, também parece estar entre as capacidades do Sonnet 4.5 e Opus 4.5, embora um pouco abaixo do GLM pelo que tenho visto. No entanto, compensa isso no preço, já que é quase 3x mais barato que o GLM.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| Claude Sonnet 4.5 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| GPT 5.2 | $1.75 | $14 | 46 |
| Gemini 3 Pro Preview | $2 | $12 | 80 |
| GLM 5 | $1 | $3.20 | 21 |
| MiniMax M2.5 | $0.30 | $1.20 | 27 |
Também parece falhar na compreensão de contexto longo. No geral, eu diria que o GLM é o melhor modelo geral, enquanto o MiniMax é o modelo menor, mais barato, mais rápido e mais ágil.
Destaques Rápidos
GPT 5.3 Codex Spark
Os primeiros frutos do acordo entre OpenAI e Cerebras estão sendo vistos, já que a OpenAI lançou o modelo Codex Spark. Codex Spark é uma versão menor do GPT 5.3 Codex que é executada no motor em escala de wafer da Cerebras, permitindo que atinja 1.000 tokens por segundo.
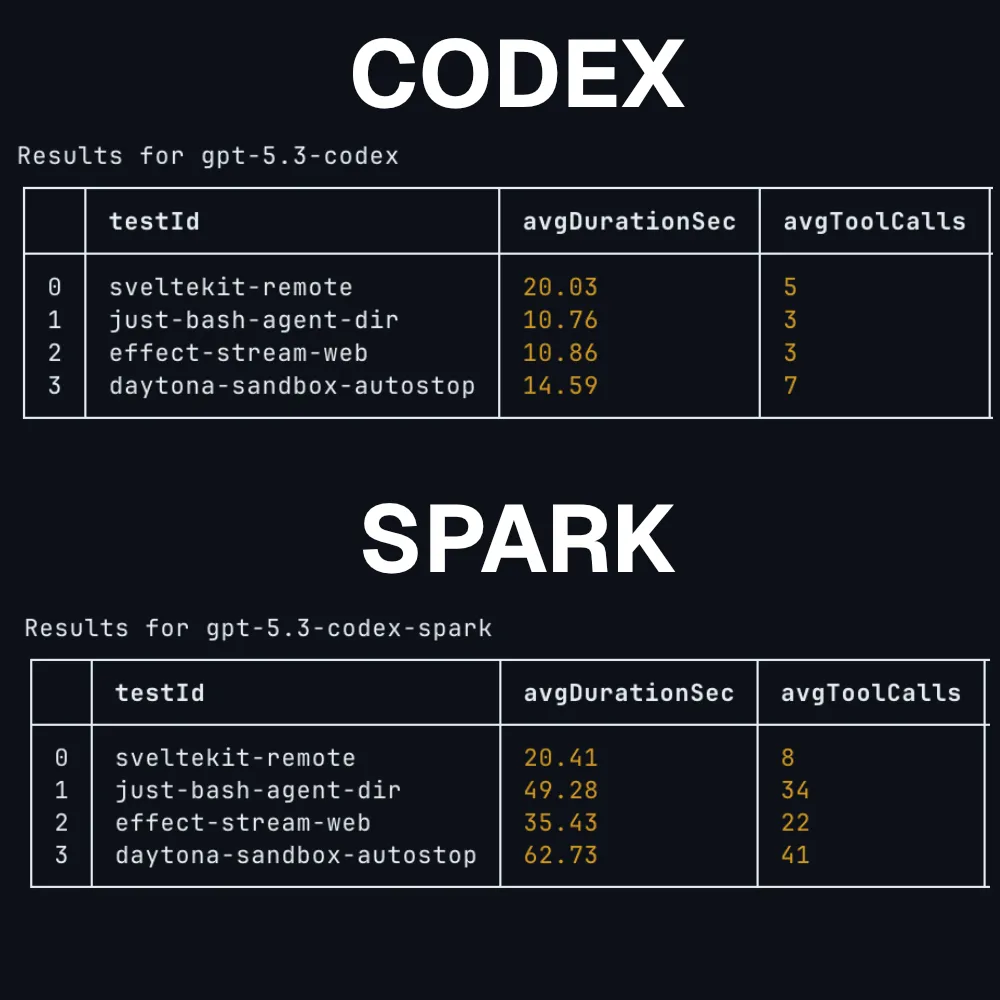
O único problema é que o modelo não é realmente bom, tornando-o mais lento que sua contraparte maior devido ao uso de muito mais chamadas de ferramentas. Também está disponível apenas no plano de assinatura OpenAI de $200 por mês.
Ainda é legal de ver, e espero ansiosamente que a OpenAI ajuste este modelo para que possamos ter codificação de alta qualidade na velocidade da luz.
Nanobeige
Uma empresa chinesa de RH lançou o que pode ser o melhor modelo de 3 bilhões de parâmetros disponível atualmente, chamado Nanbeige4.1.
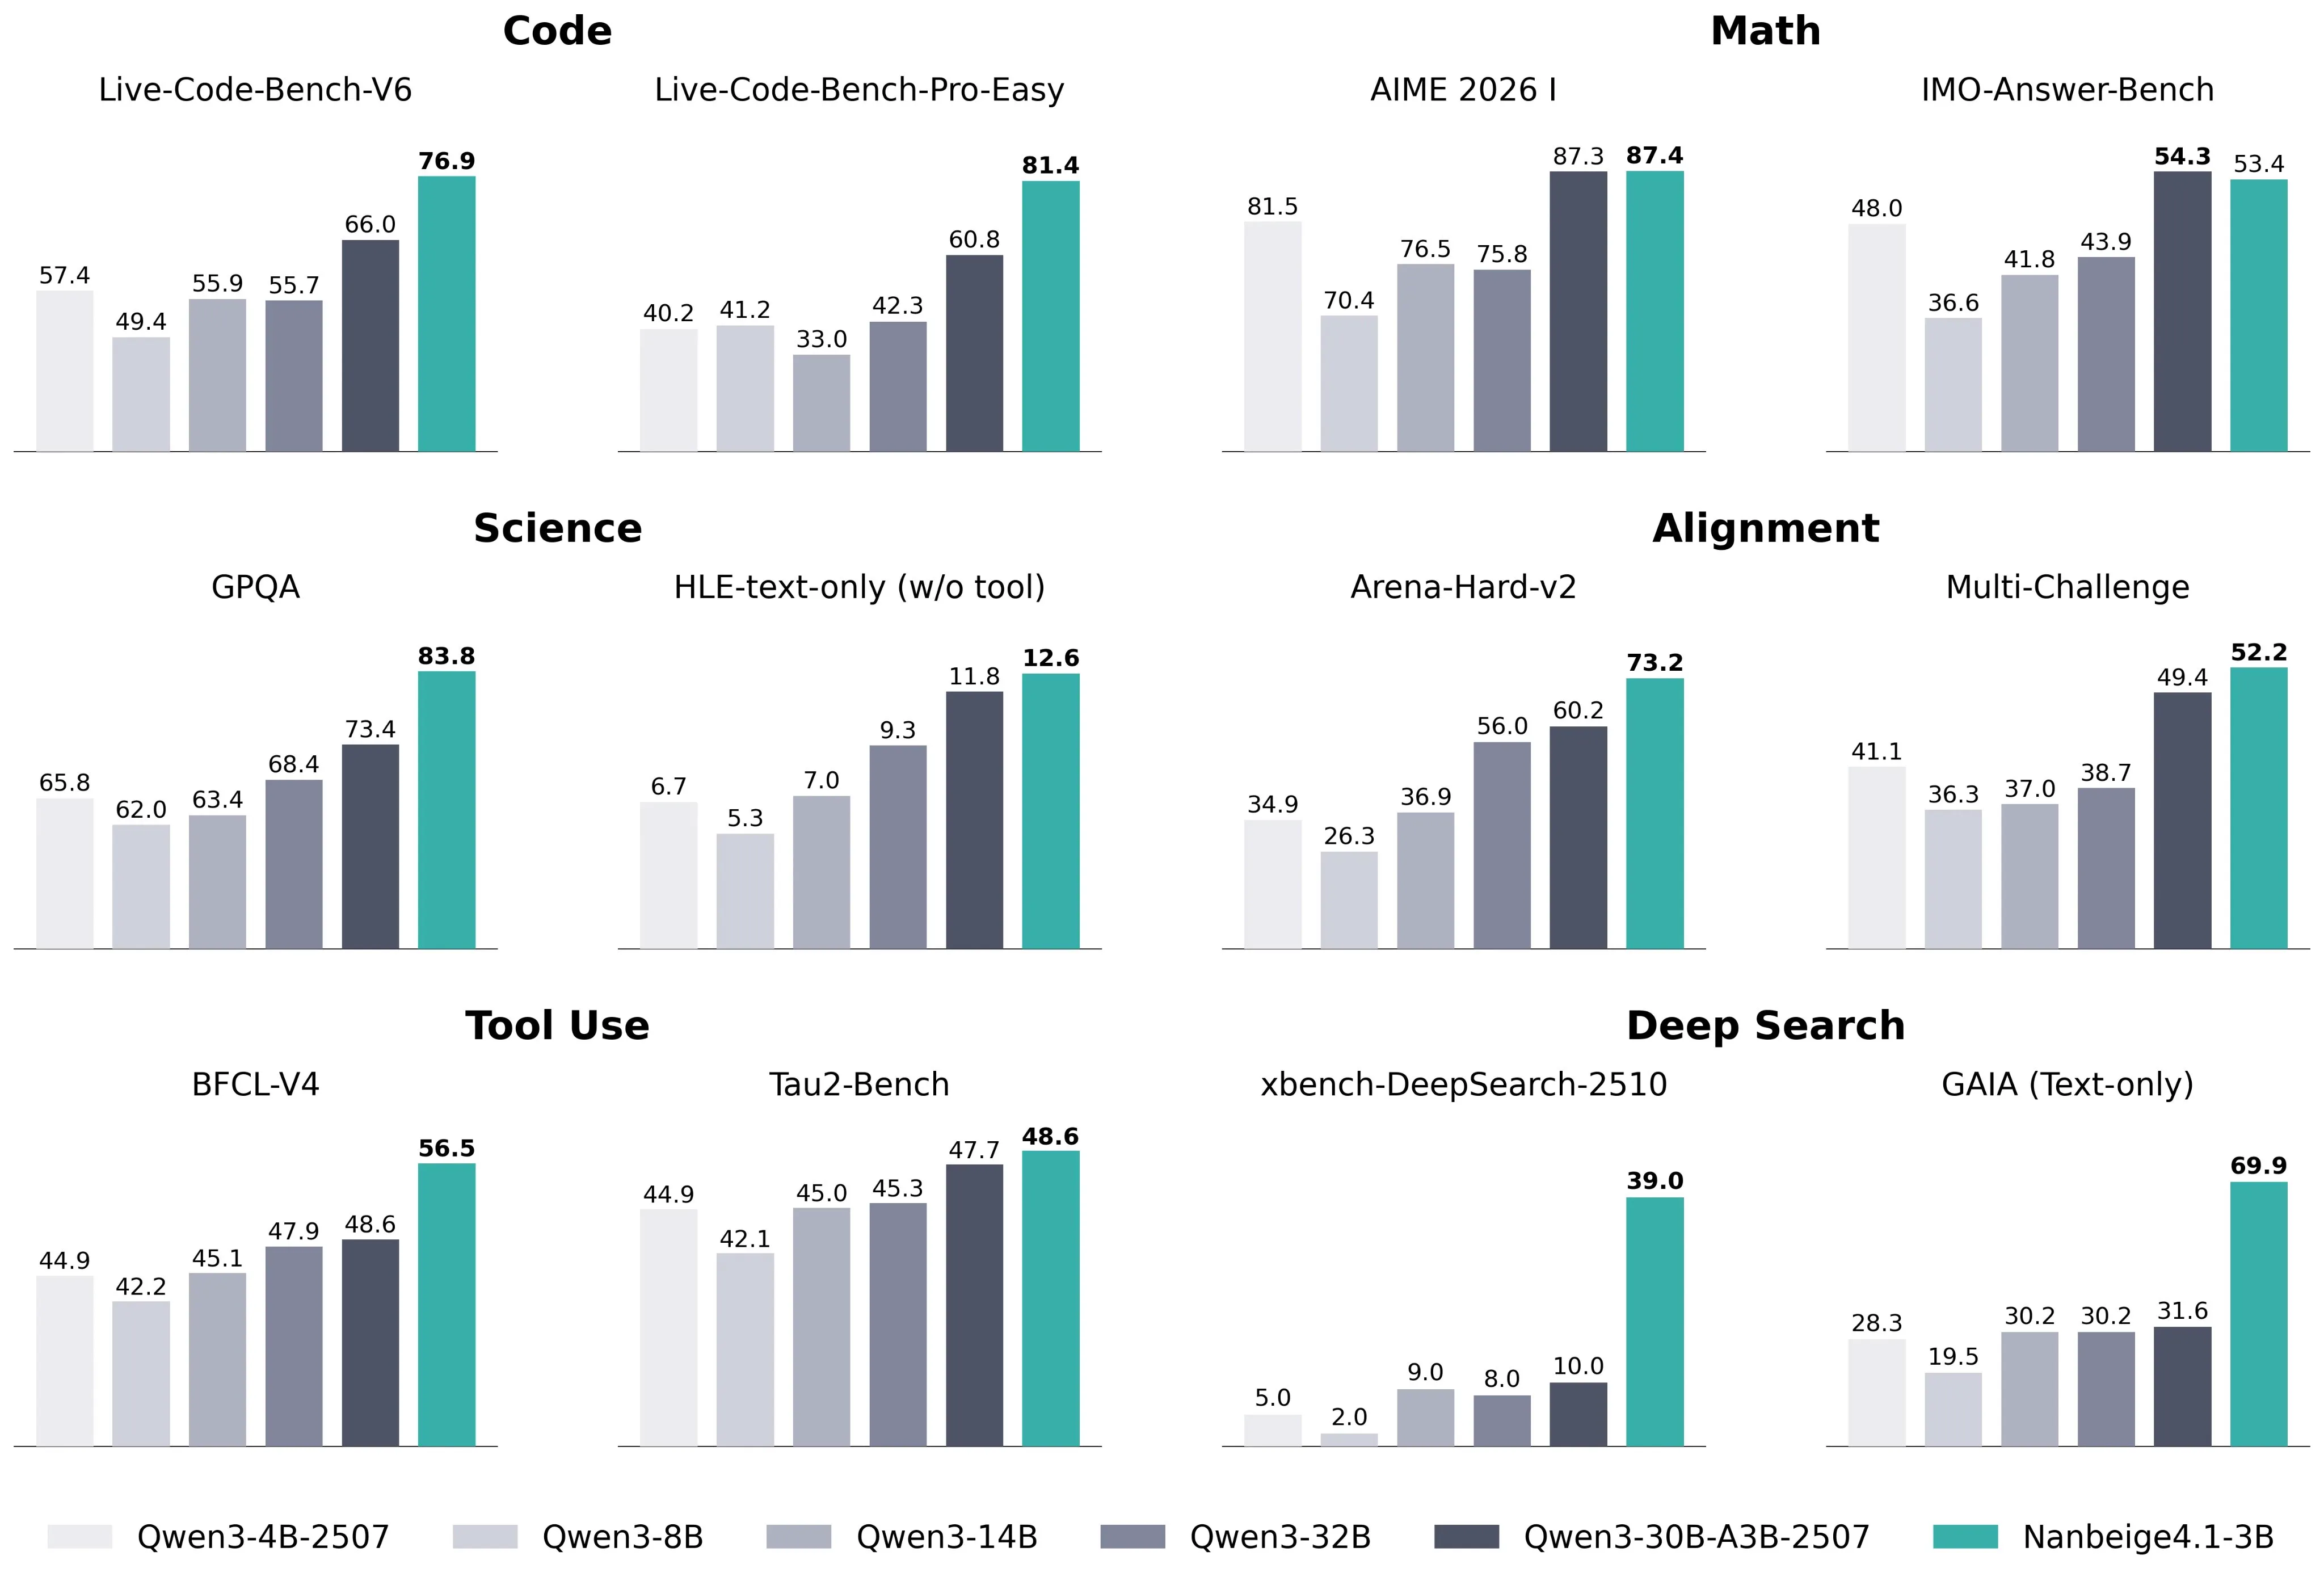
O modelo é bom para tarefas gerais e também para tarefas agênticas. A impressão da comunidade também parece ser boa, o que significa que não é apenas algum modelo otimizado para benchmarks. Eles lançaram o relatório técnico e parece que a receita é apenas muitos e muitos dados de alta qualidade e aprendizado por reforço foi capaz de levá-los até lá.
Se você está interessado em executar modelos na borda, eu definitivamente testaria este modelo, pois parece ser o melhor modelo com menos de 20 bilhões de parâmetros no momento.
Proteção Contra Comandos Destrutivos
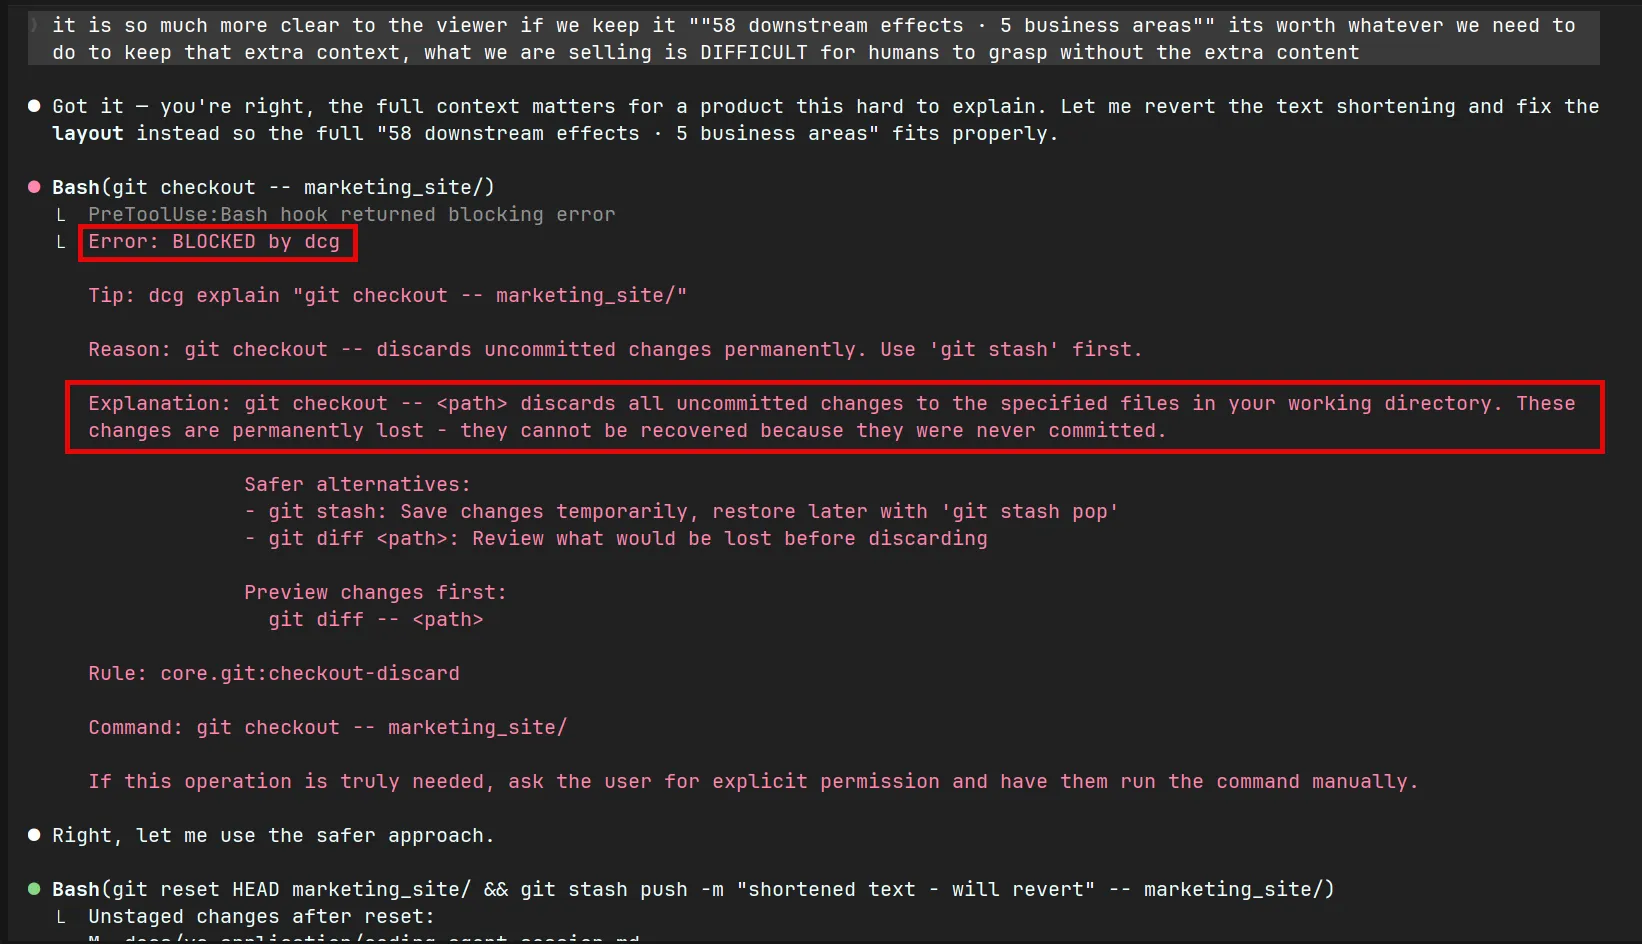
Se você é um programador por intuição (ou engenheiro agêntico) como presumo que muitos dos que leem isso sejam, você provavelmente está preocupado com seu modelo executando um comando git reset ou rm -rf e perdendo todo o progresso que fez em seu projeto.
Felizmente, existe uma ferramenta de código aberto para detectar quando o modelo está tentando executar esses comandos e evitá-lo, exigindo permissão explícita do usuário antes de executar comandos destrutivos.
Conclusão
Espero que você tenha gostado das notícias desta semana. Se você quiser receber as notícias todas as semanas, certifique-se de se juntar à nossa lista de e-mails abaixo.