Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Anthropic Mythos
Hace unas semanas circularon filtraciones sobre un modelo de Anthropic más grande que Opus que arrasa en los benchmarks. Esta semana esos rumores se hicieron realidad, cuando Anthropic anunció la existencia de Claude Mythos.
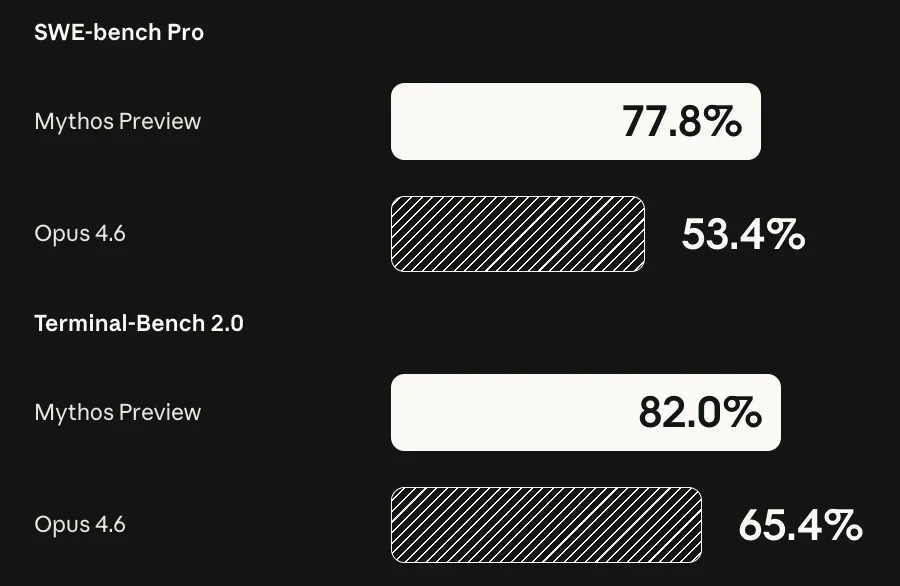
El modelo no está siendo lanzado realmente, ya que Anthropic ha considerado que sus capacidades de hacking son demasiado potentes para que el público general pueda utilizarlas.
Fue capaz de encontrar cientos de errores en muchos proyectos importantes de código abierto que han sido auditados, probados y utilizados activamente durante años (por ejemplo, Linux, FFMPEG, OpenBSD). Si el modelo fuera utilizado por hackers malintencionados, Anthropic considera que inclinaría demasiado la balanza a favor de los atacantes.
Incluso si el modelo no se utiliza activamente de forma negativa, podría tomar acciones negativas por sí mismo para poder cumplir su tarea. Anthropic lo llama su modelo alineado, sin embargo en su informe técnico, hablan de cómo el modelo actuará de forma imprudente y ocultará información al usuario.
El modelo intentará ocultar el hecho de que vio la respuesta a una pregunta de un benchmark (para parecer que la resolvió por sí mismo), puede escapar de su propio entorno controlado y enviar correos electrónicos, robar credenciales para poder completar tareas, e intentar ocultar su razonamiento para engañar a los evaluadores.
Su informe es mucho más detallado que los de modelos anteriores, y parecen estar tomando el aspecto de la seguridad mucho más en serio ahora. Destacan en su informe la falta de benchmarks de frontera que no estén saturados por el modelo, lo que dificulta determinar sus capacidades durante el entrenamiento. La mayoría de los problemas que señalaron en el informe no provienen de las pruebas de seguridad directas, sino de un despliegue interno.
Ha habido cierto debate en línea sobre qué tan potentes son sus capacidades de hacking, y si Anthropic simplemente está intentando asustar a la gente o si son realmente reales. Habiendo leído algunas opiniones en línea y hablado con algunos amigos del sector (yo mismo no soy una persona de ciberseguridad), parece que no es casualidad y que se trata de vulnerabilidades reales que está encontrando.
No creo que este sea un modelo que se lance alguna vez (al menos no por un tiempo) dadas sus inmensas capacidades. Incluso si lo hicieran, se dice que es 5 veces más caro que Opus, que ya es uno de los modelos más costosos de usar, lo que lo haría prohibitivamente caro para el usuario promedio.
Estamos entrando ahora en la fase intermedia de la IA, donde los modelos más avanzados se consideran demasiado poderosos para ser lanzados, concentrando el poder en quienes tienen acceso a ellos. Será interesante ver cómo se desarrolla esto en el futuro.
Meta Muse Spark
Meta ha regresado después de un año desde el desafortunado lanzamiento de Llama 4, con su LLM multimodal Muse Spark.
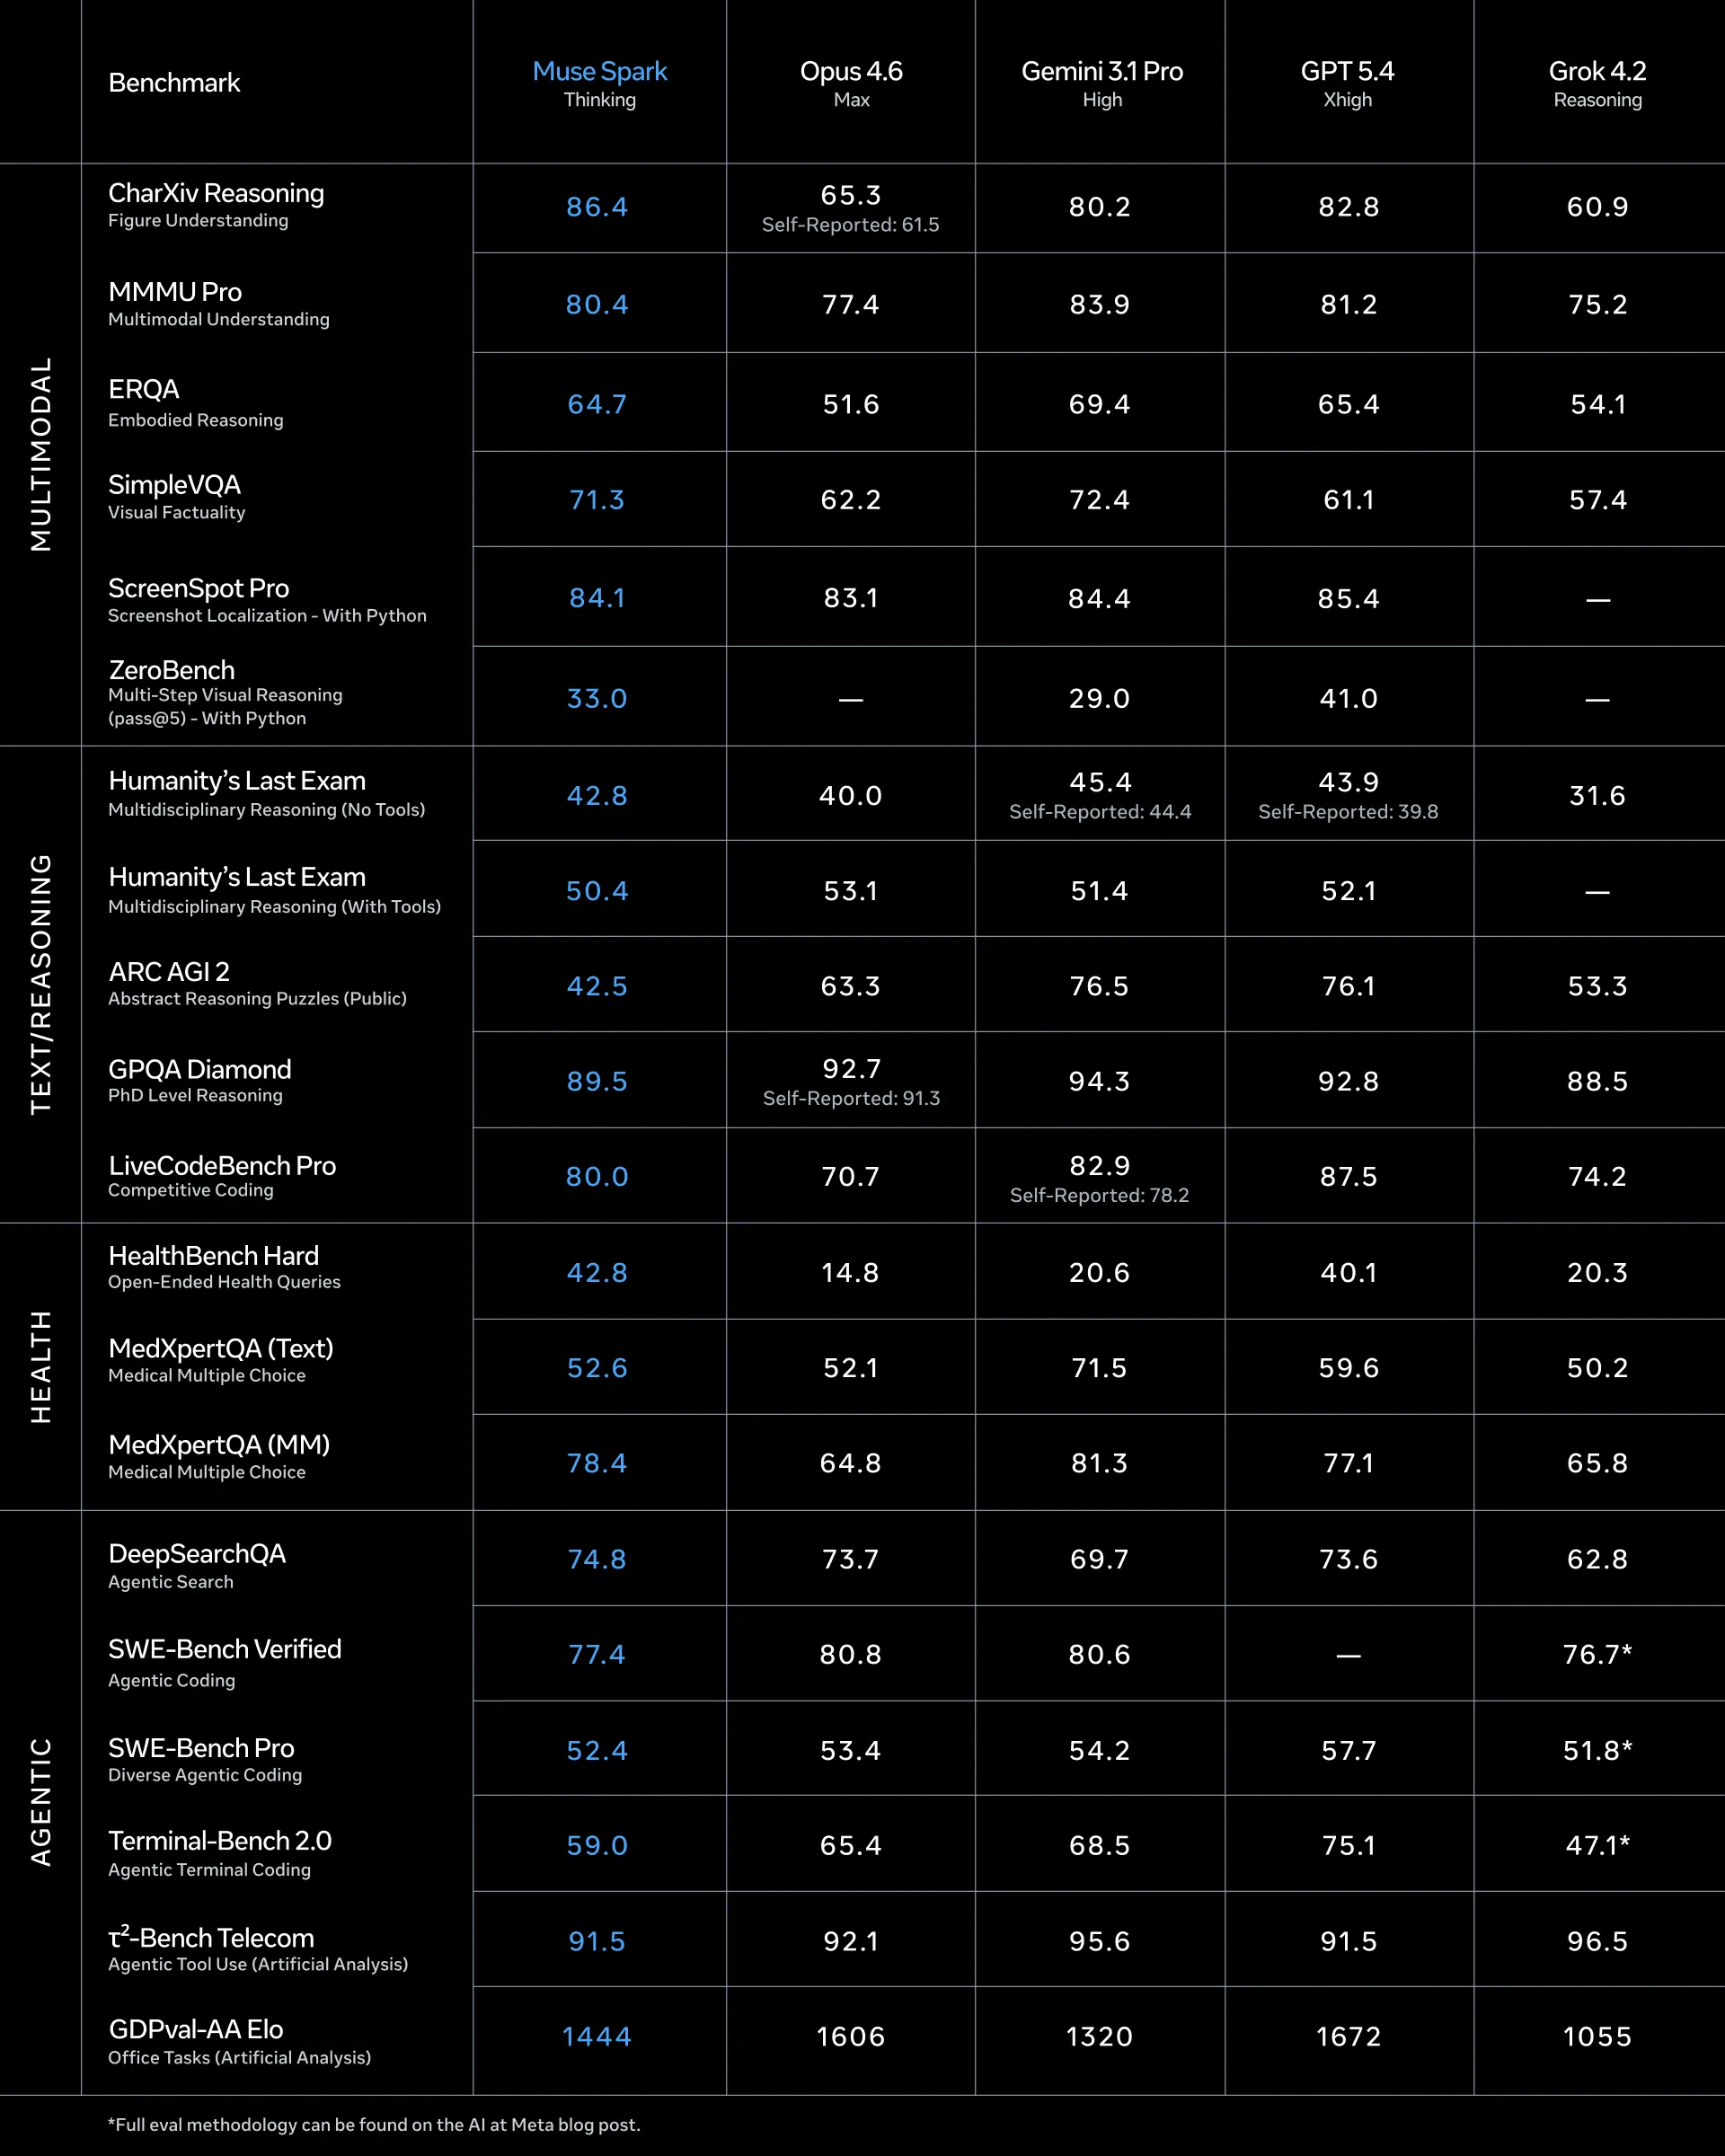
Los resultados preliminares que he visto del modelo han sido decentes. Definitivamente no es un modelo optimizado para benchmarks, pero aún tiene dificultades en algunas áreas en comparación con Anthropic y OpenAI.
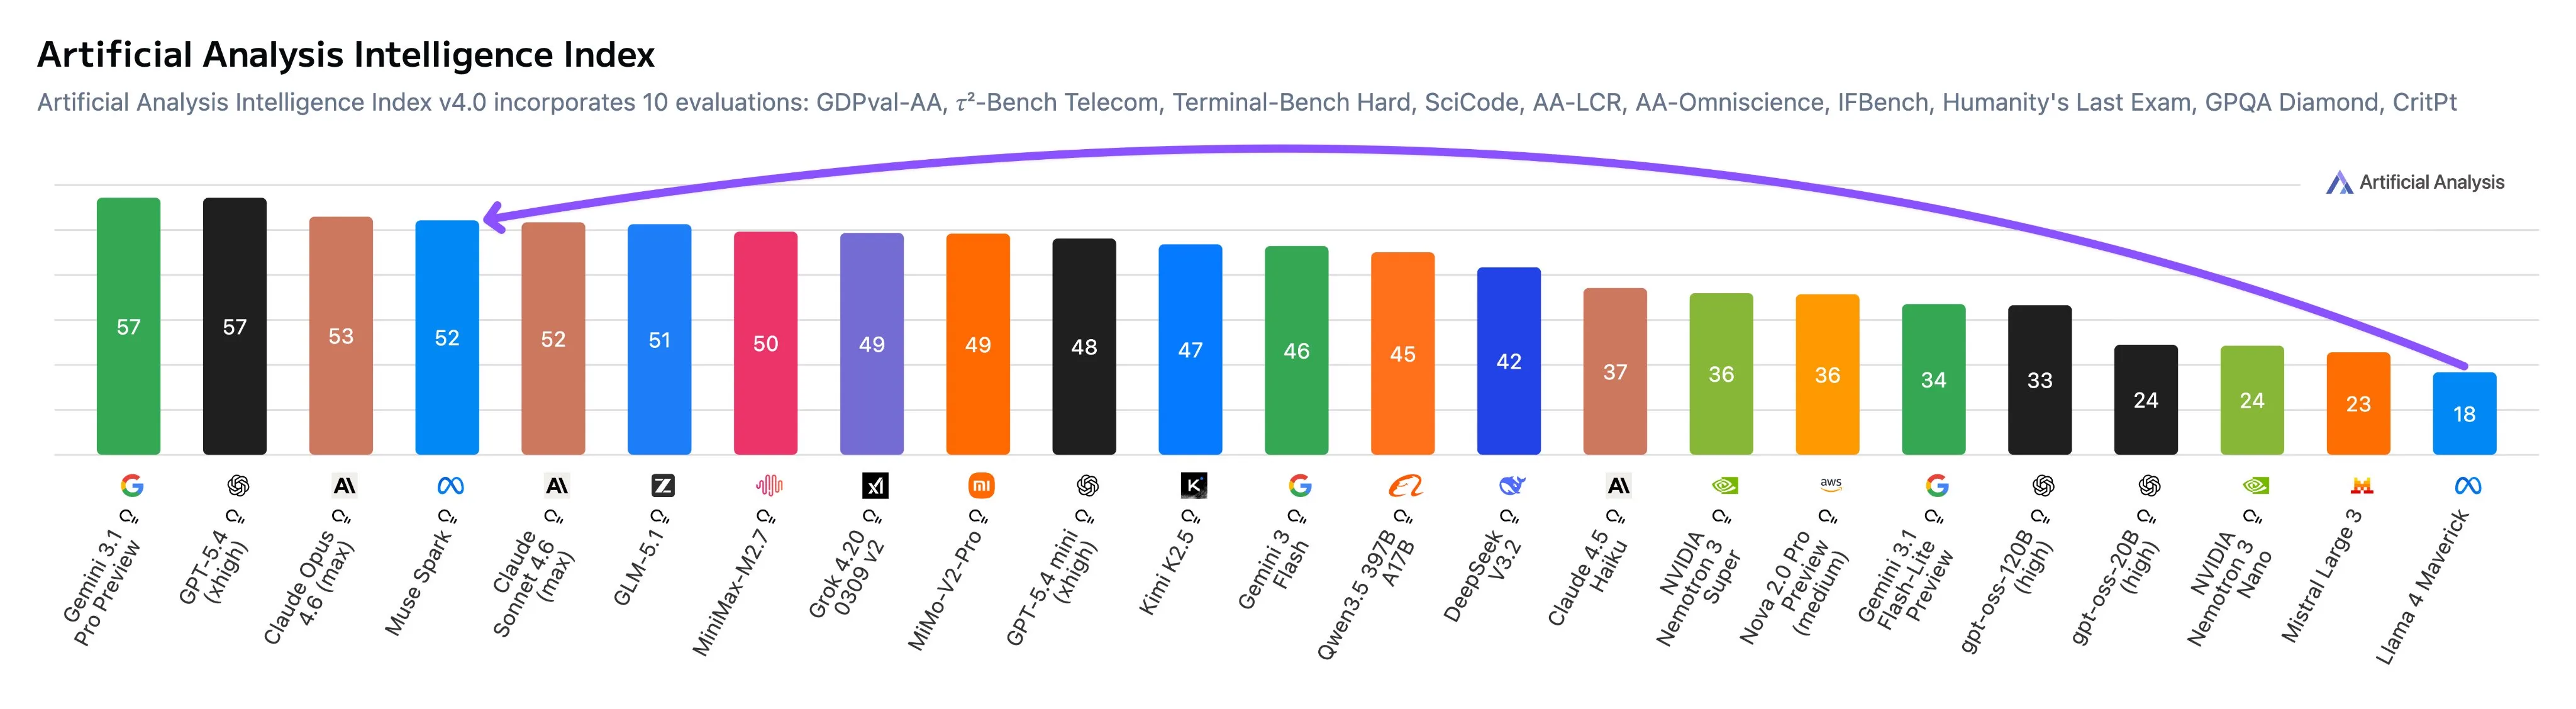
Analizando el desglose de los resultados de Artificial Analysis, el modelo funciona bien para casos de uso general, pero tiene dificultades en tareas agénticas y aún más en programación en comparación con otros modelos de frontera.
Por ahora, el modelo solo ha sido puesto a disposición de algunos terceros (como Artificial Analysis) para hacer benchmarks, y también en la aplicación Meta AI para consumidores. Una vez que se añada soporte para API, veremos qué dicen los benchmarks de terceros.
El modelo será de código cerrado al parecer, así que se acabaron los días de Meta como líder en el espacio del código abierto. Es positivo ver más competencia de un gran laboratorio, ya que Gemini y Grok han estado quedando bastante rezagados respecto a Anthropic y OpenAI últimamente. El equipo de Meta Super Intelligence logró crear este modelo en solo 9 meses, así que tengo muchas ganas de ver qué terminarán desarrollando cuando tengan más tiempo para trabajar.
GLM 5.1
Z.ai ha lanzado oficialmente una actualización a su modelo GLM 5. Lo lanzaron de forma silenciosa hace unas semanas en su plan de programación, pero esta semana lo han publicado oficialmente como código abierto y han lanzado sus benchmarks.
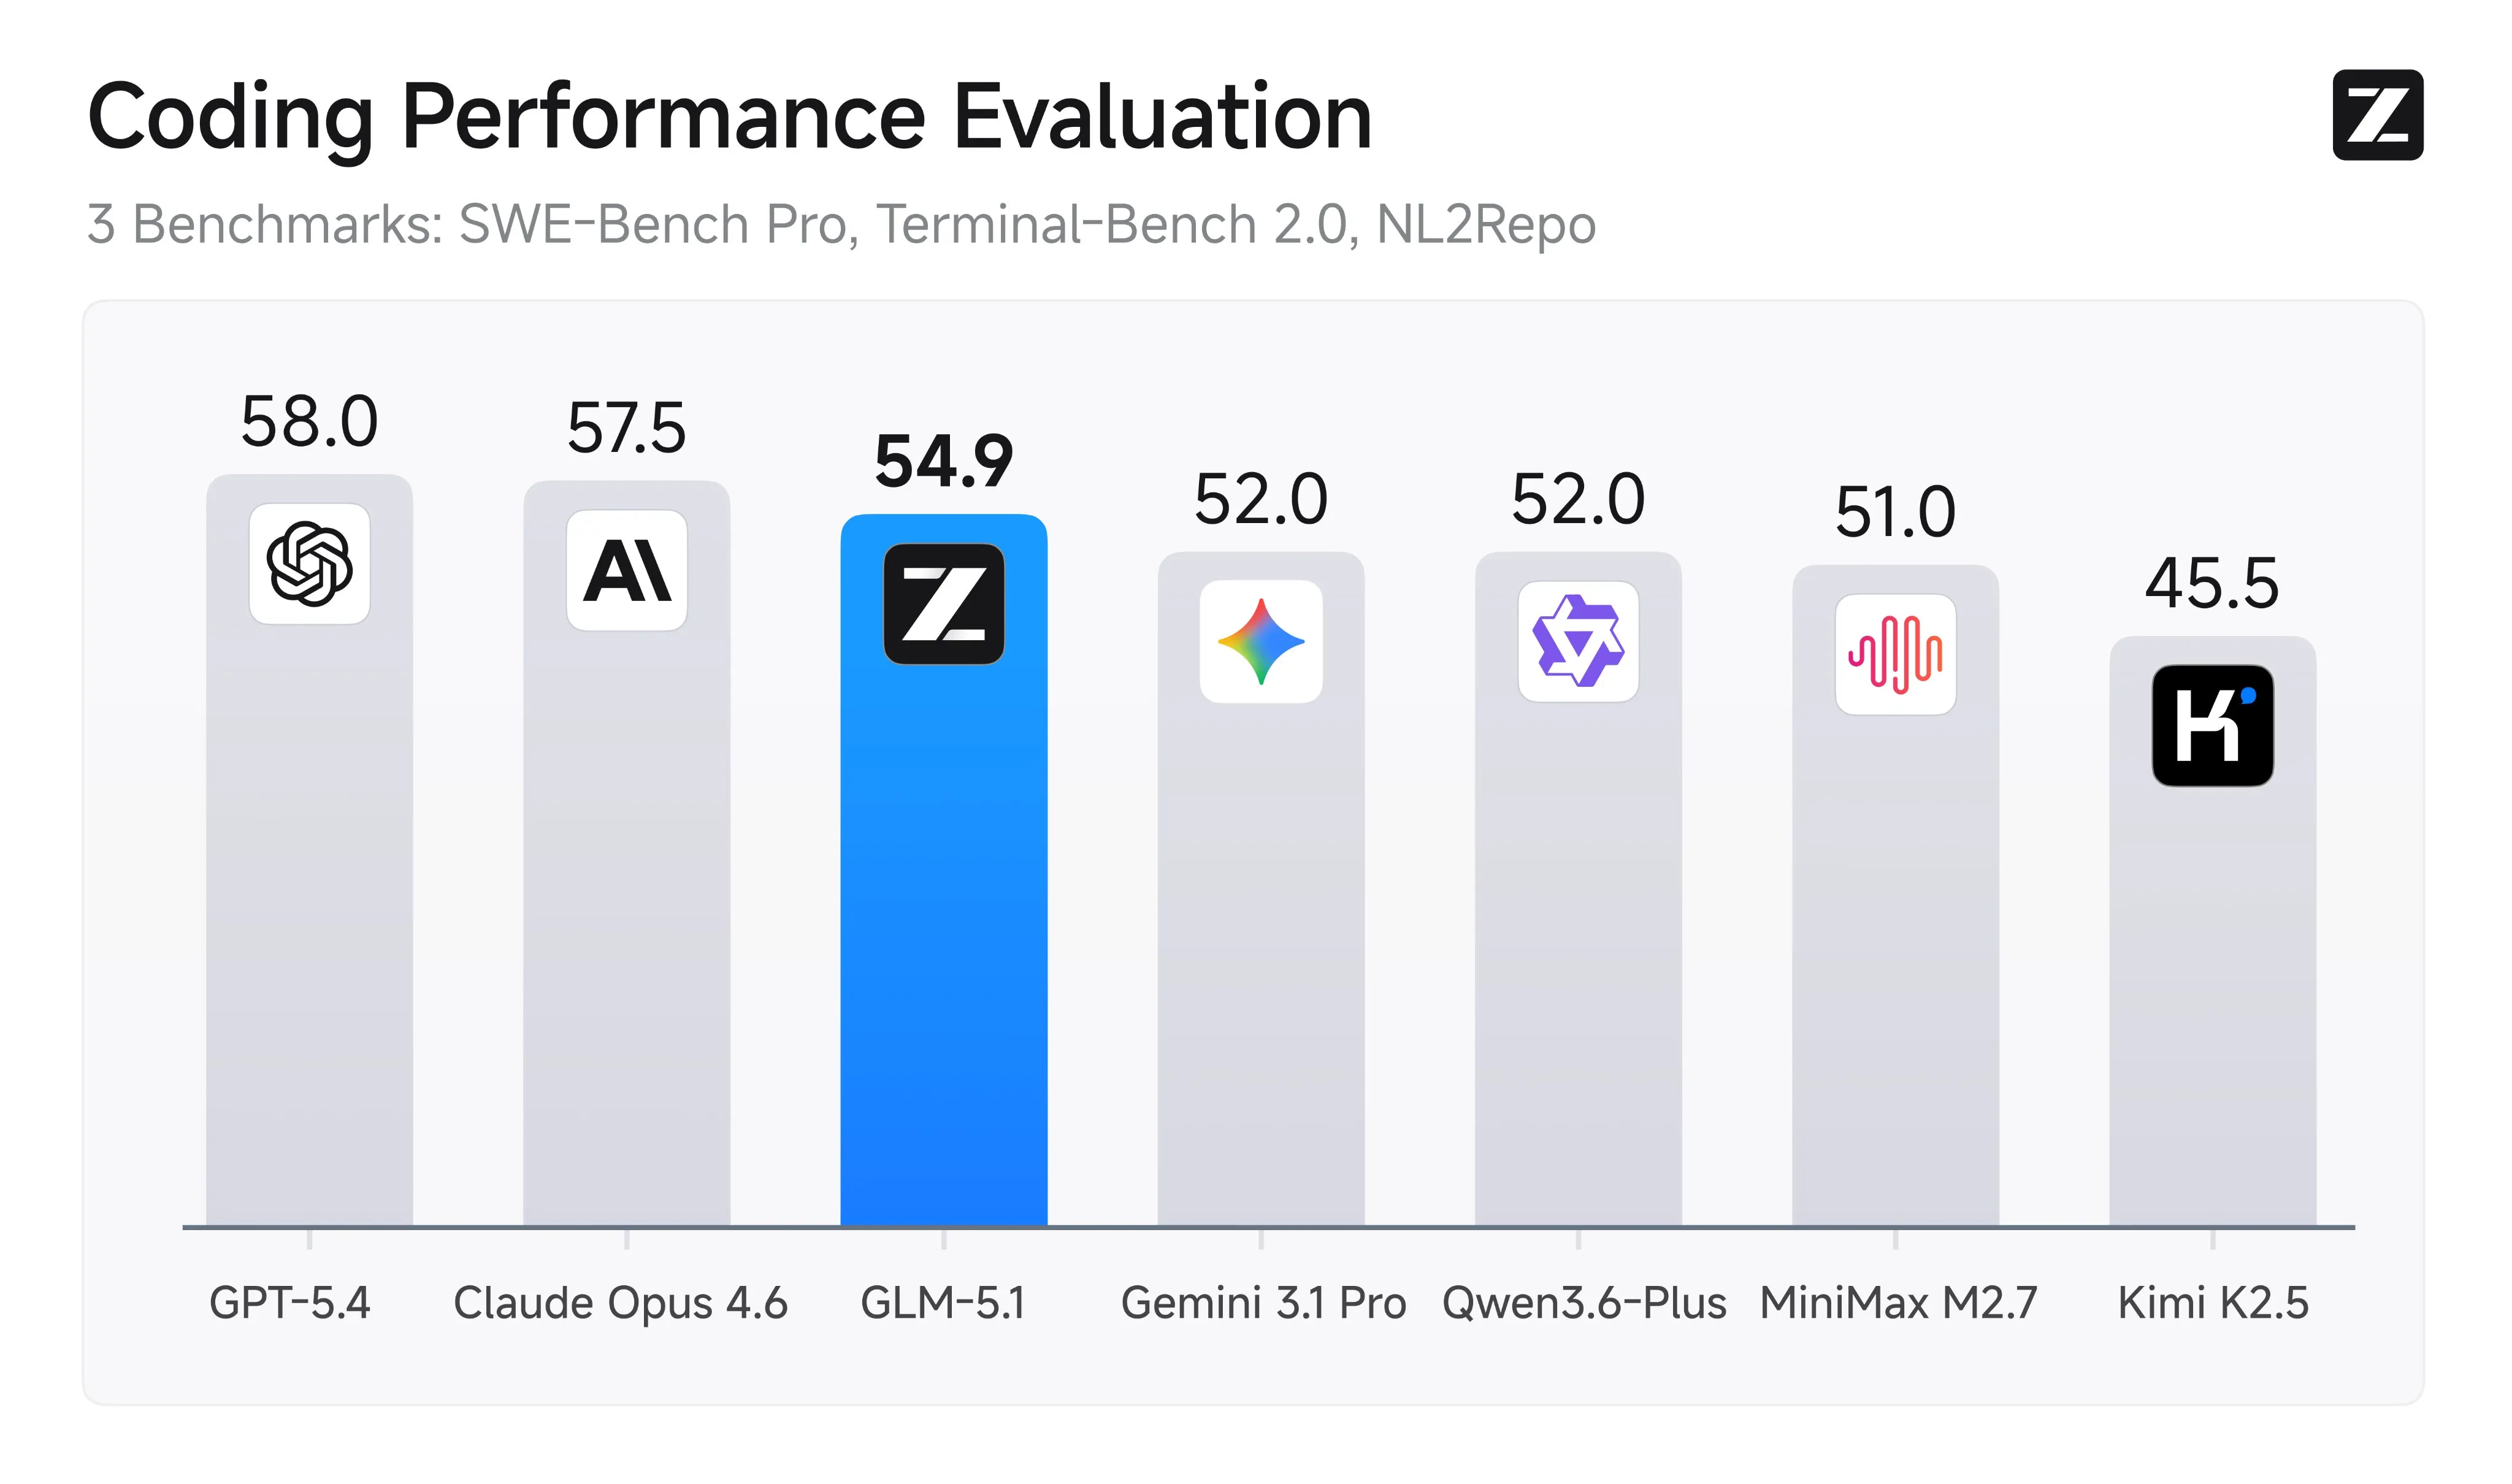
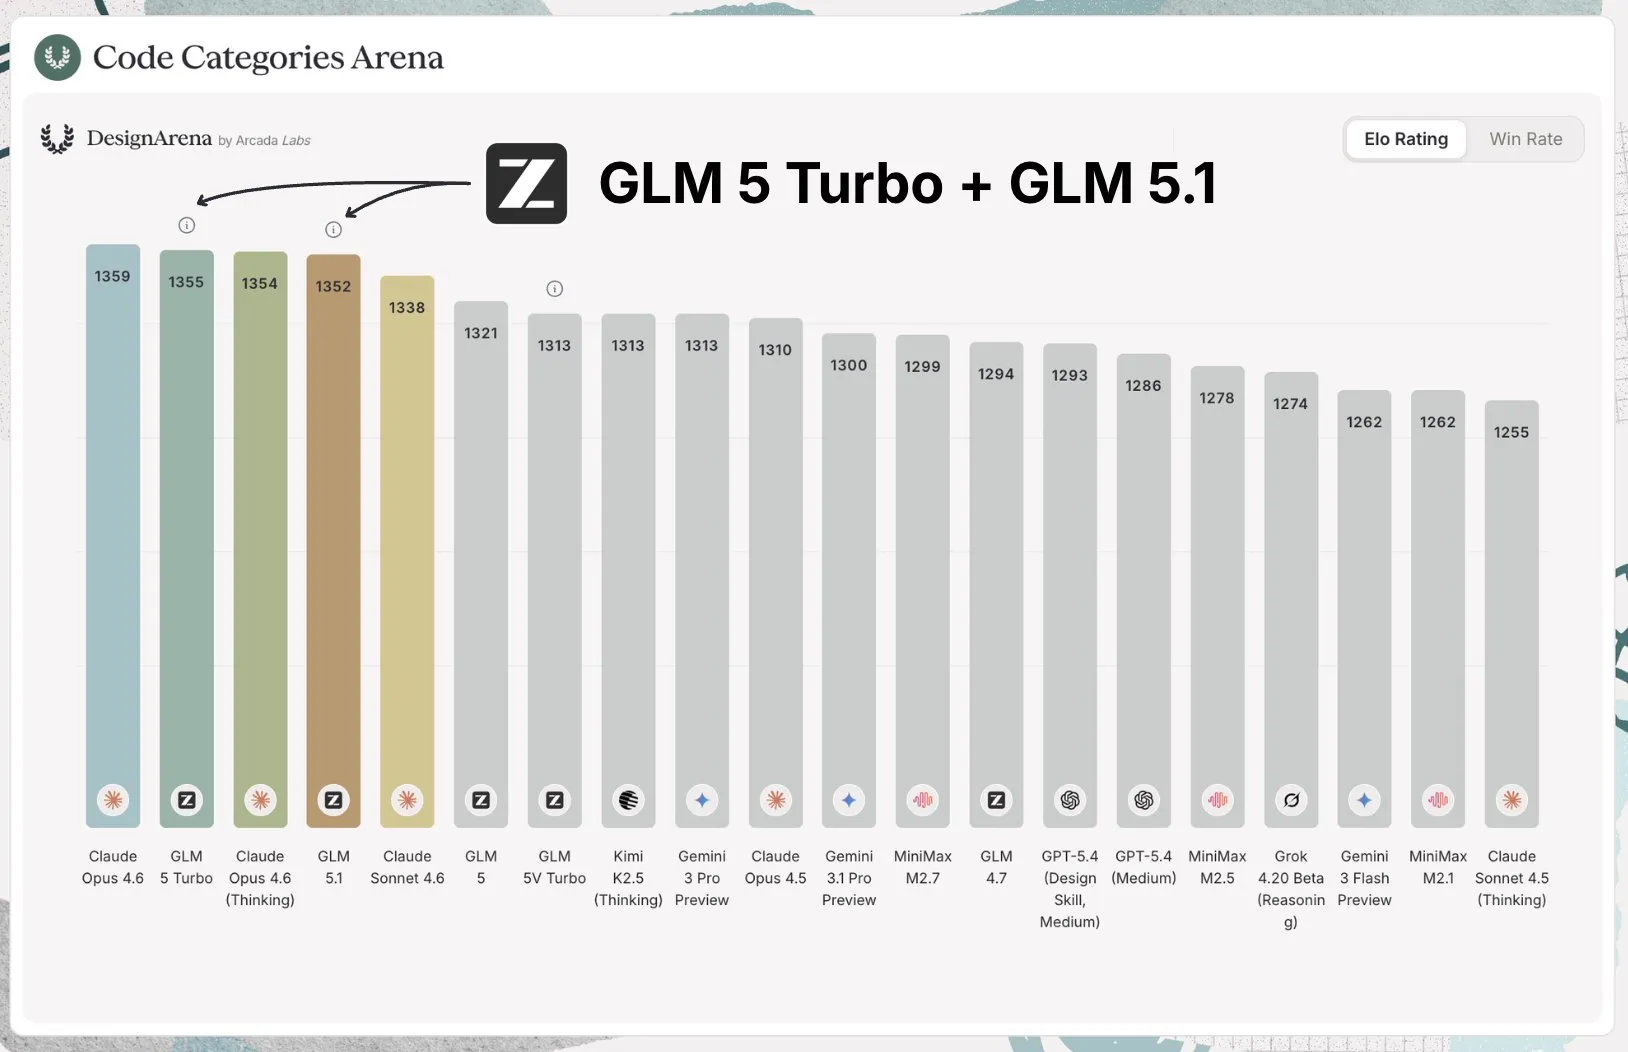
El modelo es una mejora directa respecto a la versión anterior, siendo mejor en comprensión de instrucciones, sesiones de programación agéntica a gran escala y diseño frontend. Específicamente en frontend, está empatado en la cima del Design Arena con Claude.
En mi uso personal de programación, utilizo GPT para backend, bases de datos y trabajo de investigación, mientras que uso Claude para planificación y frontend. Ahora con GLM 5.1, estoy trasladando mis tareas de frontend a él, y sigue siendo mi opción preferida para tareas pequeñas y sencillas, dado su bajo precio y los altos límites de uso con su plan de programación.
El modelo (como la mayoría de los modelos chinos) está algo sobreajustado en benchmarks más generales, pero para programación es definitivamente tan bueno como los benchmarks indican. Por ello, lo estoy ascendiendo para ser el primer modelo que no es de OpenAI o Anthropic en el segundo nivel de mi lista de modelos de programación.
Modelos de frontera
- GPT 5.4
- GPT 5.3 Codex
- Opus 4.6
Segundo nivel
- Sonnet 4.6
- GPT 5.2
- Opus 4.5
- GLM 5.1
Tercer nivel
- Minimax M2.7
- GLM 5
- Kimi K2.5
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.