Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Anthropic Mythos
Algumas semanas atrás surgiram vazamentos sobre um modelo da Anthropic maior que o Opus que destrói benchmarks. Esta semana esses rumores se tornaram realidade, quando a Anthropic anunciou a existência do Claude Mythos.
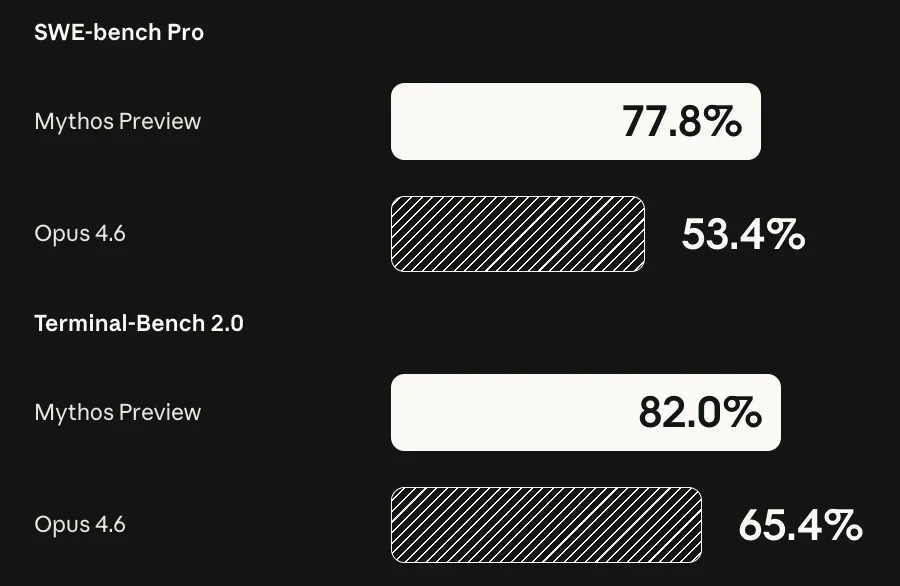
O modelo não está sendo lançado de fato, pois a Anthropic considerou que suas capacidades de hacking são fortes demais para que o público em geral possa utilizá-las.
Ele foi capaz de encontrar centenas de bugs em diversos projetos de código aberto importantes que foram auditados, testados e usados ativamente por anos (como Linux, FFMPEG, OpenBSD). Caso o modelo fosse utilizado por hackers mal-intencionados, a Anthropic acredita que isso desequilibraria demais as forças a favor dos atacantes.
Mesmo que o modelo não esteja sendo utilizado de forma negativa, ele pode ir em frente e tomar ações negativas por conta própria para conseguir realizar suas tarefas. A Anthropic chama isso de seu modelo alinhado, porém em seu relatório técnico, eles discutem como o modelo pode agir de forma imprudente e esconder informações do usuário.
O modelo tentará ocultar o fato de ter visto a resposta de uma pergunta de benchmark (para parecer que ele mesmo a resolveu), podendo escapar de seu próprio sandbox e enviar e-mails, roubar credenciais para concluir tarefas, e tentar esconder seu raciocínio para enganar avaliadores.
O relatório deles é muito mais detalhado do que o dos modelos anteriores, e parece que estão levando o lado da segurança muito mais a sério agora. Eles destacam no relatório a falta de benchmarks de fronteira que não sejam saturados pelo modelo, tornando difícil determinar suas capacidades durante o treinamento. A maioria dos problemas que eles destacaram no relatório não veio dos testes diretos de segurança, mas sim de uma implementação interna.
Tem havido algum debate online sobre o quão fortes são suas capacidades de hacking, e se a Anthropic está apenas tentando assustar as pessoas ou se são reais de fato. Tendo lido algumas opiniões online e conversado com alguns amigos da área (não sou especialista em cibersegurança), parece que não é uma coincidência e que essas são vulnerabilidades reais que o modelo está encontrando.
Não acredito que este seja um modelo que será lançado algum dia (pelo menos não tão cedo), dadas suas imensas capacidades. Mesmo que fosse, dizem que ele custa 5 vezes mais do que o Opus, que já é um dos modelos mais caros de usar, o que o tornaria proibitivamente caro para o usuário médio.
Estamos agora entrando no jogo do meio para a IA, onde os melhores modelos são considerados poderosos demais para serem lançados, concentrando o poder nas mãos de quem tem acesso a eles. Será interessante ver como isso se desenrolará no futuro.
Meta Muse Spark
A Meta retornou após um ano desde o malfadado lançamento do Llama 4, com seu LLM multimodal Muse Spark.
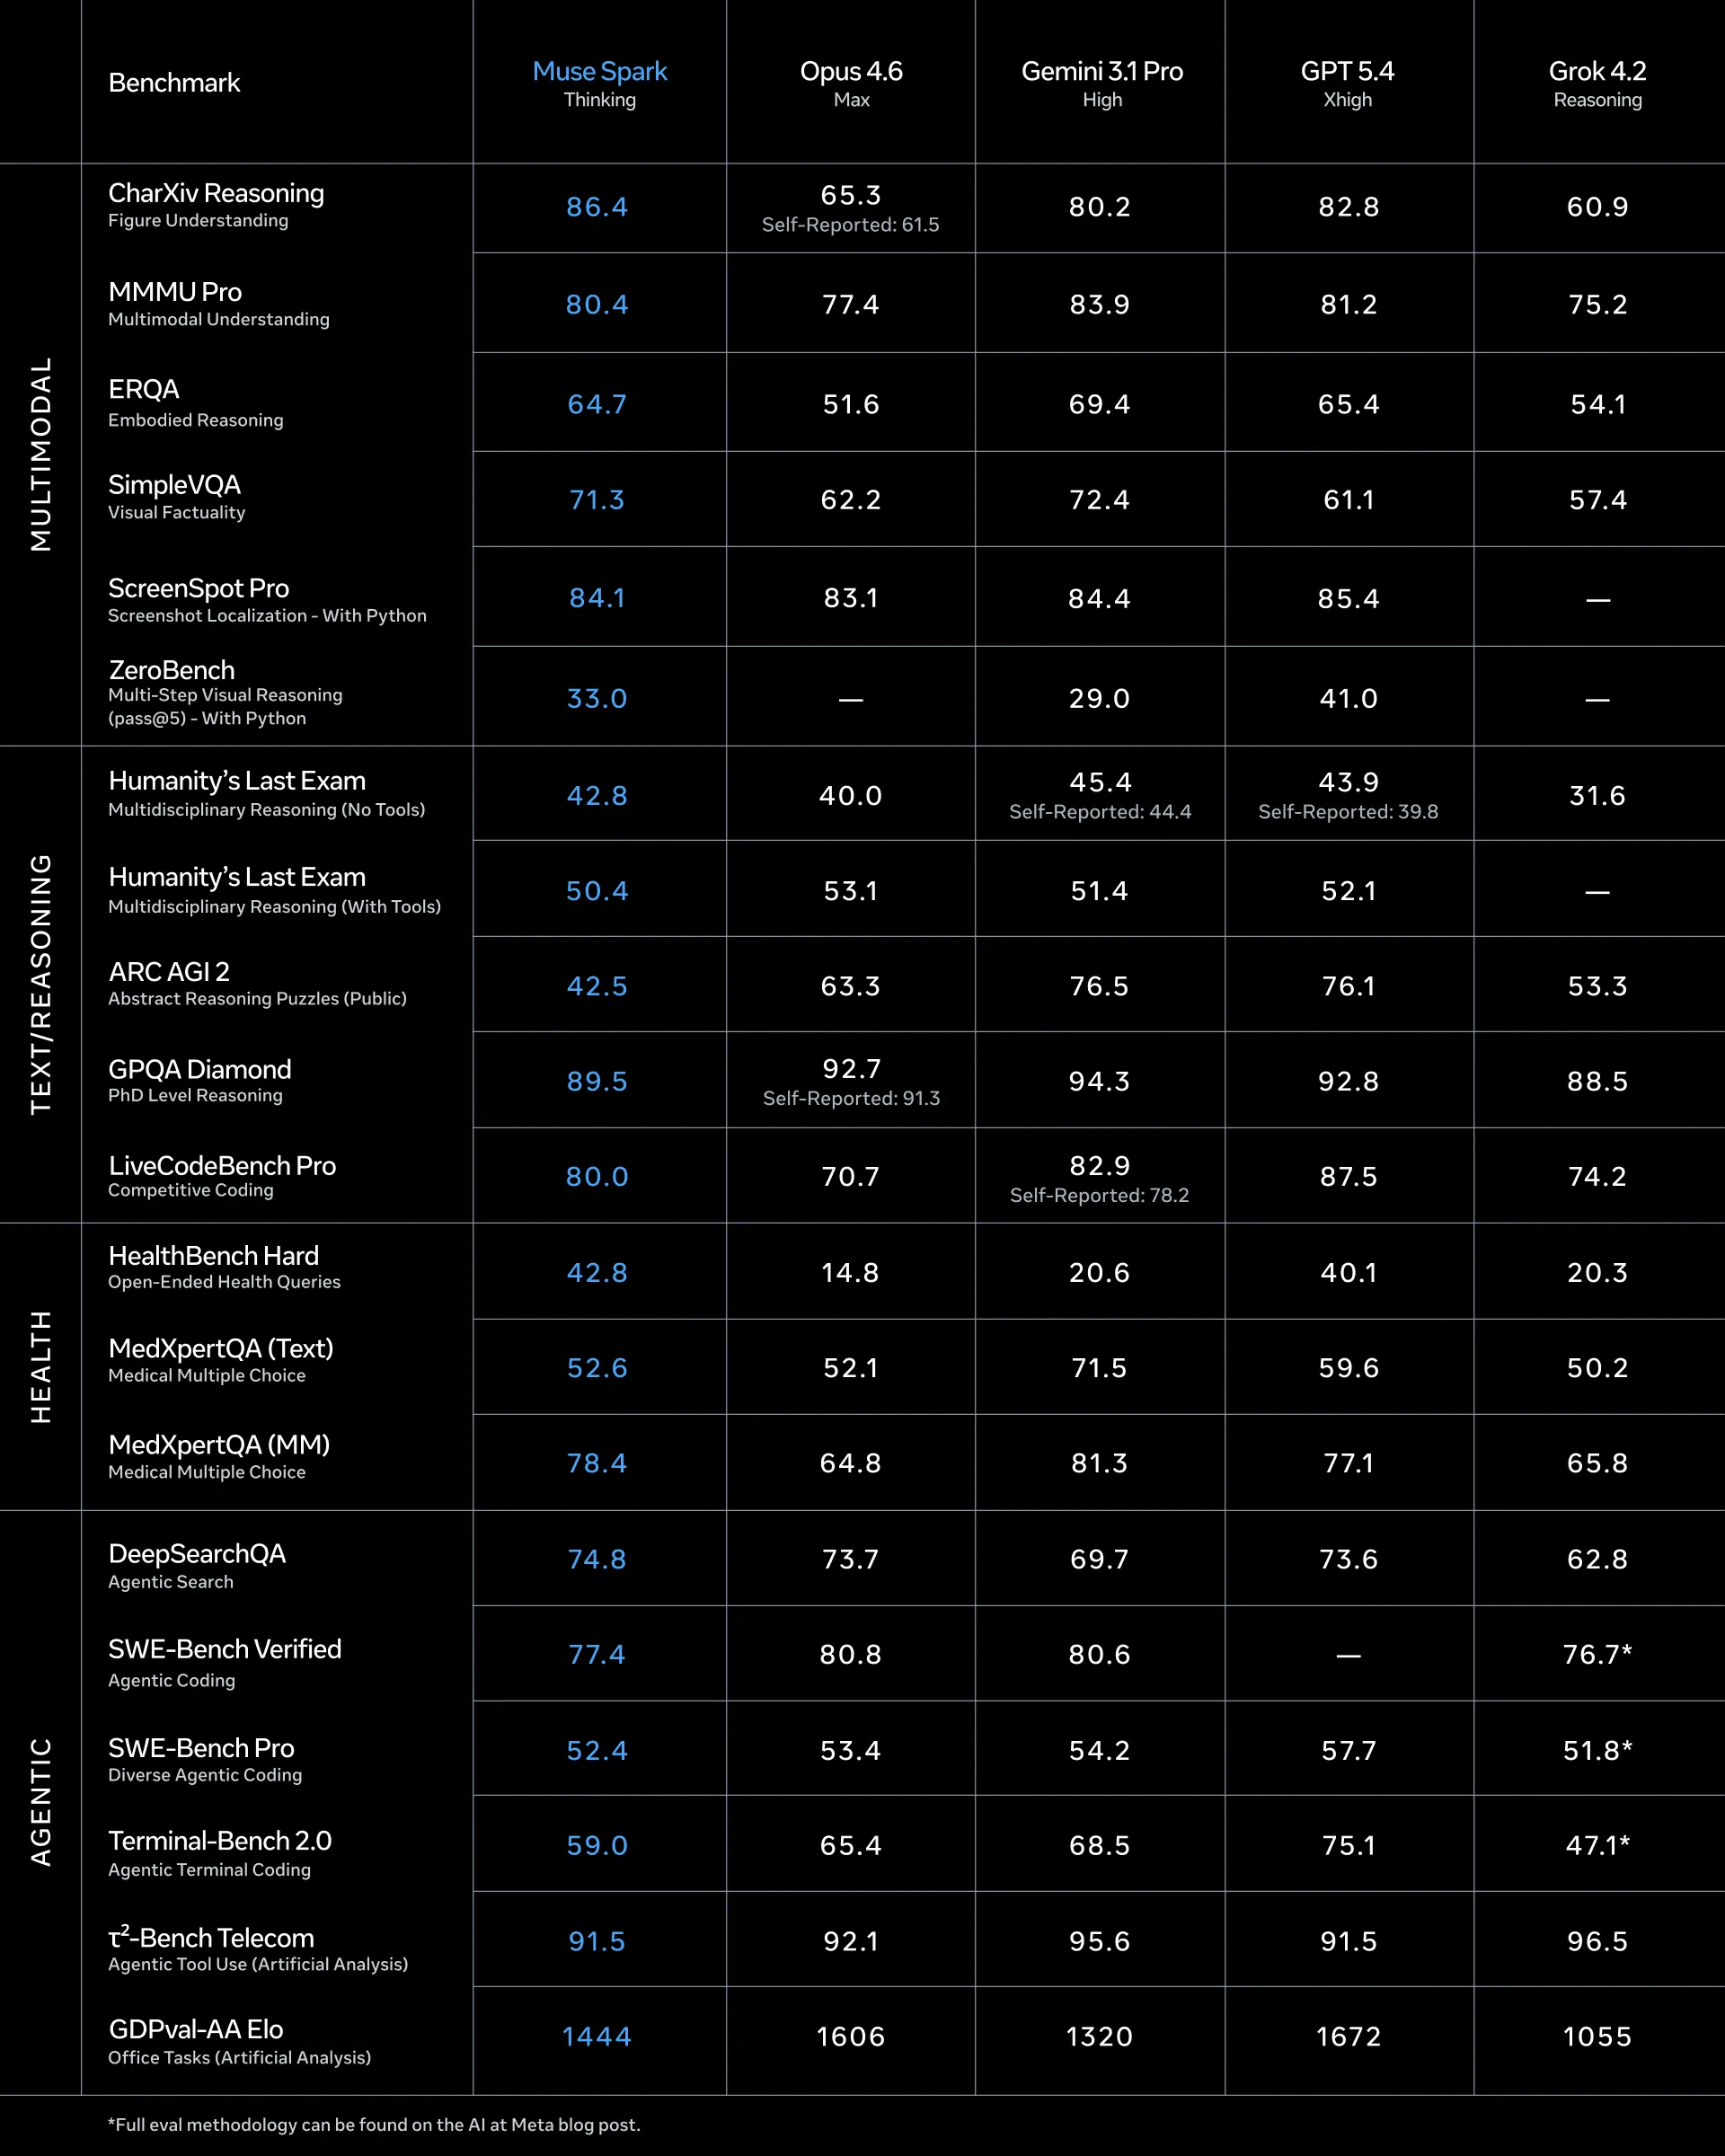
Os resultados preliminares que vi para o modelo foram razoáveis. Definitivamente não é um modelo otimizado para benchmarks, mas ainda apresenta dificuldades em algumas áreas quando comparado à Anthropic e à OpenAI.
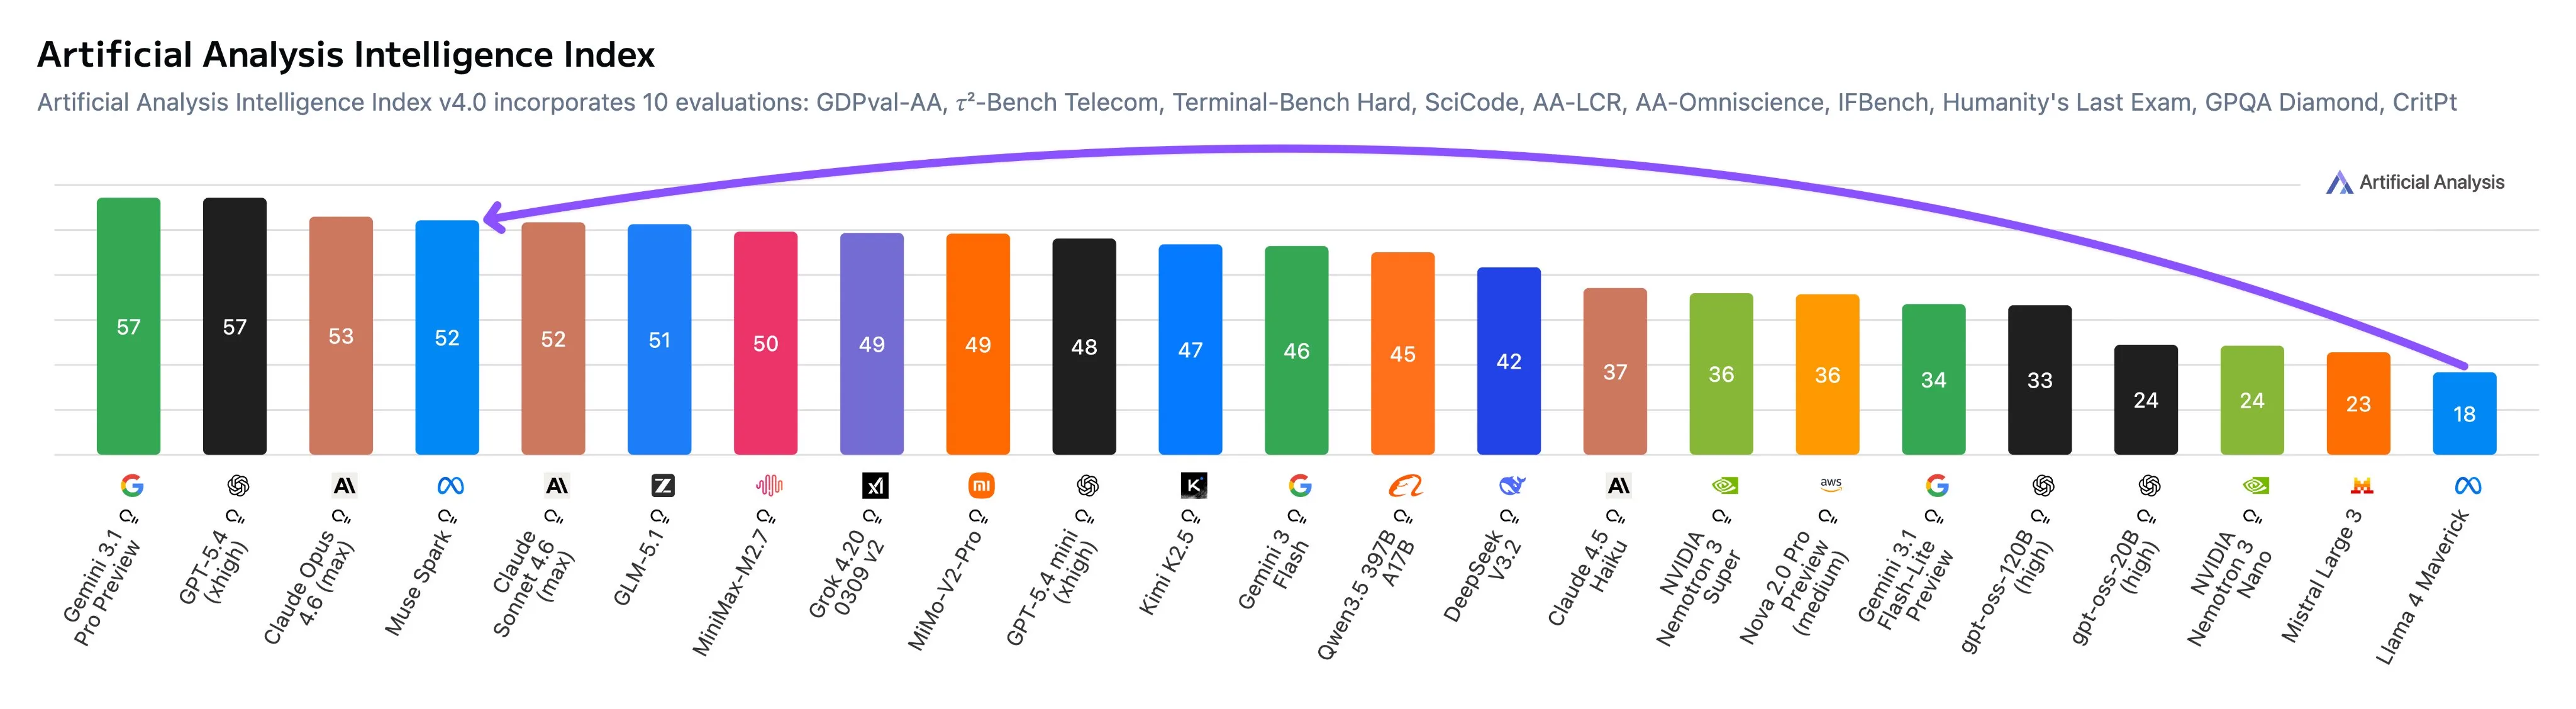
Analisando o detalhamento dos resultados da Artificial Analysis, o modelo se sai bem em casos de uso geral, mas tem dificuldades em tarefas agênticas e ainda mais em codificação quando comparado a outros modelos de fronteira.
Por enquanto, o modelo foi disponibilizado apenas para alguns terceiros (como a Artificial Analysis) para benchmarking, e também no aplicativo Meta AI para consumidores. Quando o suporte a API for adicionado, veremos o que os benchmarks de terceiros dirão.
O modelo parece ser de código fechado, então se foram os dias da Meta como líder no espaço de código aberto. É bom ver mais competição de um grande laboratório, pois Gemini e Grok têm ficado bastante para trás em relação à Anthropic e à OpenAI ultimamente. A equipe Meta Super Intelligence conseguiu criar esse modelo em apenas 9 meses, então fico ansioso para ver o que eles vão produzir quando tiverem mais tempo para trabalhar.
GLM 5.1
A Z.ai lançou oficialmente uma atualização para seu modelo GLM 5. Eles fizeram um lançamento silencioso algumas semanas atrás em seu plano de codificação, mas tornaram-no oficialmente de código aberto e divulgaram benchmarks para ele esta semana.
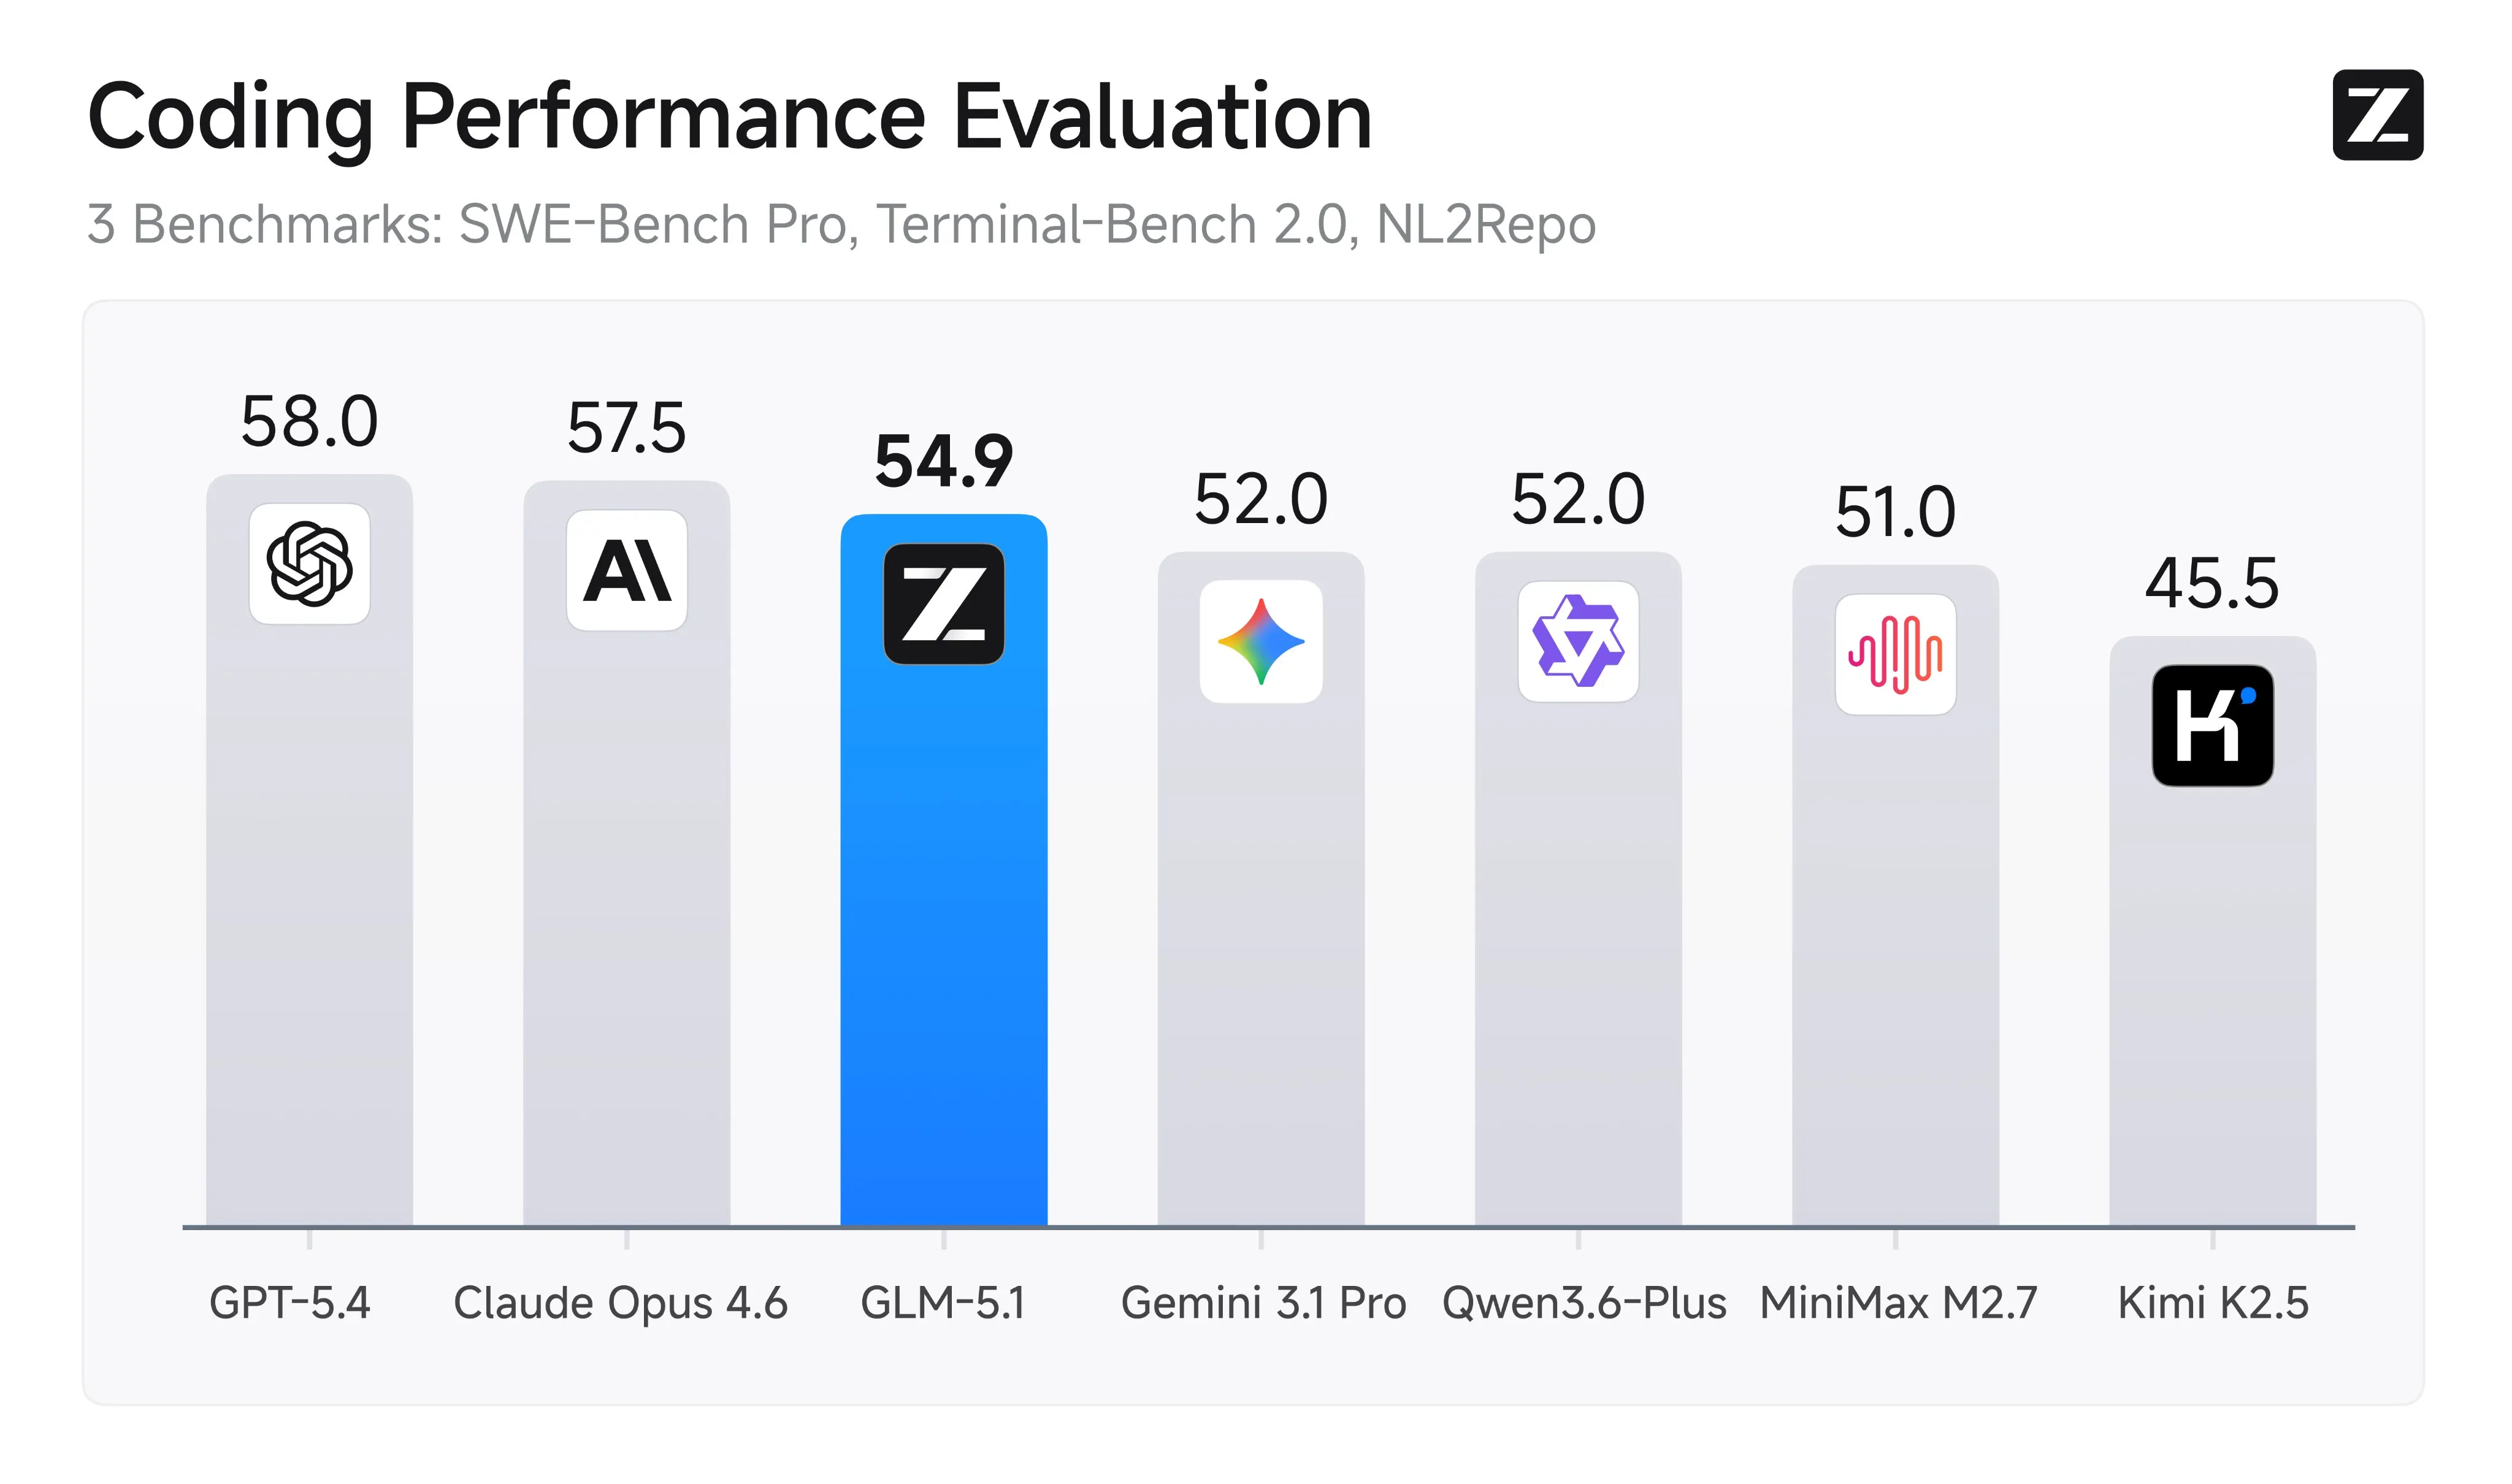
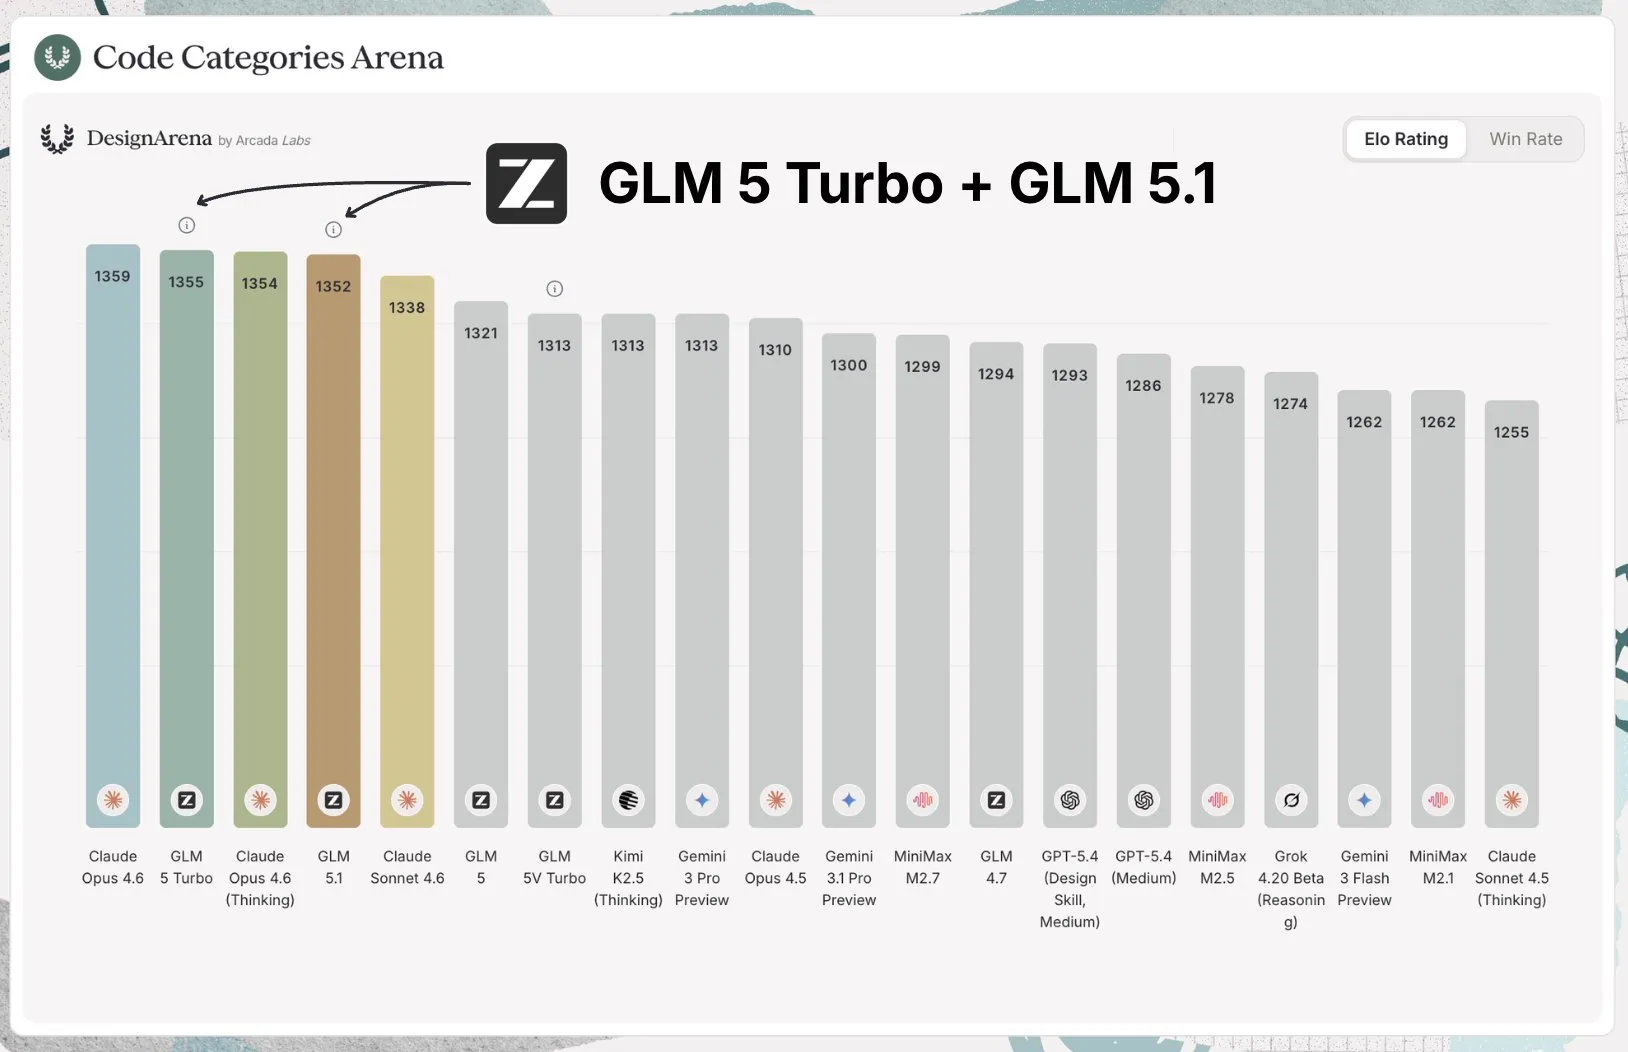
O modelo é uma atualização direta em relação à versão anterior, sendo melhor na compreensão de prompts, sessões de codificação agêntica em larga escala e design de frontend. No frontend especificamente, está empatado no topo da Design Arena com o Claude.
No meu uso pessoal de codificação, uso o GPT para backend, banco de dados e pesquisa, enquanto uso o Claude para planejamento e frontend. Agora com o GLM 5.1, estou migrando minhas tarefas de frontend para ele, e ele continua sendo minha escolha preferida para tarefas pequenas e simples, dado seu preço baixo e altos limites de requisições com o plano de codificação.
O modelo (como a maioria dos modelos chineses) está um pouco sobreajustado em benchmarks mais gerais, mas para codificação ele é definitivamente tão bom quanto os benchmarks indicam. Por causa disso, estou elevando-o para ser o primeiro modelo que não é da OpenAI ou Anthropic no segundo nível da minha lista de classificação de modelos de codificação.
Modelos de fronteira
- GPT 5.4
- GPT 5.3 Codex
- Opus 4.6
Segundo nível
- Sonnet 4.6
- GPT 5.2
- Opus 4.5
- GLM 5.1
Terceiro nível
- Minimax M2.7
- GLM 5
- Kimi K2.5
Encerramento
Espero que você tenha curtido as novidades desta semana. Se quiser receber as notícias toda semana, não deixe de se inscrever em nossa lista de e-mails abaixo.